Grafana y LDAP: Aumenta la seguridad en menos de 5 minutos

Grafana y LDAP: Aumenta la seguridad en menos de 5 minutos

Este artículo cubrirá cómo integrar rápidamente Grafana y el servidor LDAP para aumentar la seguridad de su aplicación

Grafana es una de las herramientas de panel más utilizadas, principalmente para las plataformas de observabilidad en entornos de carga de trabajo en la nube. Pero ninguna de estas herramientas está completa hasta que pueda configurarlas para cumplir con sus estándares de seguridad. La seguridad se está volviendo cada vez más importante y esto es especialmente cierto cuando hablamos de cualquier componente relacionado con la nube. Por lo tanto, este tema siempre debe ser algo que cualquier arquitecto de la nube tenga en mente cuando esté definiendo o implementando cualquier pieza de software hoy en día.

Y en ese punto, la integración LDAP es una de las principales cosas que siempre necesitarás hacer. No conozco ninguna empresa, grande o pequeña, que permita el uso de cualquier herramienta con una interfaz gráfica de usuario si no está conectada al directorio corporativo.

Así que, veamos cómo podemos implementar esto con una herramienta popular como Grafana. En mi caso, voy a usar una versión en contenedor de Grafana, pero los pasos y cosas a hacer siguen siendo los mismos sin importar el modelo de implementación.

La tarea que vamos a realizar se basa en tres pasos:

  • Habilitar la configuración de LDAP
  • Configuración básica de LDAP
  • Configuración de mapeo de grupos

Lo primero que necesitamos modificar es el grafana.ini añadiendo el siguiente fragmento:

    [auth.ldap]
    enabled = true
    config_file = /etc/grafana/ldap.toml

Eso significa que estamos habilitando la autenticación basada en LDAP y estableciendo la ubicación del archivo de configuración de LDAP. Este ldap.toml tiene toda la configuración necesaria para el LDAP:

    [[servers]]
    host = "localhost"
    port = 389
    use_ssl = false
    start_tls = false
    ssl_skip_verify = false
  
    bind_dn = "XXXXXX-XXXXXXXXX"
    bind_password = "XXXXXX"
    
	search_filter = "(&(sAMAccountName=%s)(memberOf=ADMIN_GROUP))"
    search_base_dns = [DC=example,DC=org"]

  
    [servers.attributes]
    member_of = "member"
    email =  "mail"
    name = "givenName"
    surname = "sn"
    username = "sAMAccountName"

    [[servers.group_mappings]]
    group_dn = "*"
    org_role = "Admin"

La primera parte se refiere a la conexión principal. Estableceremos la ubicación del host y el puerto, el usuario administrador y la contraseña. Después de eso, necesitaremos una segunda sección que defina search_filter y search_base_dns para definir los usuarios que pueden acceder al sistema.

Finalmente, tenemos otra sección para definir el mapeo entre los atributos de LDAP y los atributos de Grafana para poder recopilar los datos del LDAP.

    [servers.attributes]
    member_of = "member"
    email =  "mail"
    name = "givenName"
    surname = "sn"
    username = "sAMAccountName"

Además, podemos definir los privilegios que los diferentes grupos permiten tener a los varios org_roles en Grafana, como puedes ver en el fragmento a continuación:

    [[servers.group_mappings]]
    group_dn = "*"
    org_role = "Admin"

Con todos esos cambios en su lugar, necesitas reiniciar el servidor de Grafana para ver toda esta configuración aplicada. Después de ese punto, puedes iniciar sesión usando las credenciales de LDAP como puedes ver en la imagen a continuación y ver todos los datos recuperados del servidor LDAP:

Grafana y LDAP: Aumenta la seguridad en menos de 5 minutos

Usando el servidor admin por defecto, también puedes usar una nueva función para probar la configuración de LDAP usando la opción LDAP que puedes ver en la imagen a continuación:

Grafana y LDAP: Aumenta la seguridad en menos de 5 minutos

Y luego puedes buscar un Usuario y verás cómo este usuario se desempeñará en el servidor de Grafana:

  • Verificar los atributos que se mapearán del servidor LDAP al servidor Grafana
  • También verificar el estado de actividad y el rol permitido a este usuario

Puedes ver un ejemplo en la imagen a continuación:

Espero que este artículo te ayude a mejorar la configuración de seguridad en tus instalaciones de Grafana para integrarse con el servidor LDAP. Si deseas ver más información sobre este y temas similares, te animo a que eches un vistazo a los enlaces que encontrarás debajo de estas oraciones.
Integración de TIBCO BW y EMS

Integración de TIBCO BW y EMS

TIBCO BW admite muchos métodos de integración diferentes y cientos de conectores que te permiten conectarte a cualquier fuente posible. Pero la verdad debe ser dicha, EMS es uno de los conectores estándar que necesitas habilitar. Es por eso que TIBCO BW y EMS generalmente van juntos cuando se trata de una Plataforma de Integración adecuada.

El soporte JMS para TIBCO BW está listo para usar, pero como cualquier otra implementación de JMS, necesitas proporcionar las bibliotecas del cliente para establecer una conexión real.

Para hacer eso, desde TIBCO BW 6, se proporciona una forma sencilla para simplificar ese proceso, y esto es lo que vamos a cubrir en este artículo.

Descripción del problema

Lo primero es saber que necesitas hacer algo y lo más importante es aprender a entender qué tipo de error está relacionado con este problema. Podrías encontrar dos errores diferentes dependiendo de dónde estés probando esto: en tiempo de diseño o en tiempo de ejecución.

Si estamos hablando de un problema en tiempo de ejecución, puedes ver un rastro similar a este:

2022-06-02T13:27:15,867 ERROR [pool-13-thread-2] c.t.b.thor.runtime.model.Constituent - Se ha producido el siguiente error para "nombre: test-app versión: 1.0.0.qualifier nombre del paquete: test-app " que necesita ser resuelto.
2022-06-02T13:27:15,878 ERROR [pool-13-thread-2] c.t.b.thor.runtime.model.Constituent - TIBCO-BW-FRWK-600053: No se pudo inicializar el Componente BW [ComponentStarter].
<CausedBy> com.tibco.bw.core.runtime.api.BWEngineException: TIBCO-BW-CORE-500232: No se pudo inicializar el Componente BW [ComponentStarter], Aplicación [test-app:1.0] debido a un error de inicialización de actividad.
<CausedBy> com.tibco.bw.core.runtime.ActivityInitException: TIBCO-BW-CORE-500408: No se pudo inicializar la actividad ProcessStarter [JMSReceiveMessage] en el proceso [com.test.Starter], módulo [test-app] **debido a un error inesperado en el ciclo de vida de la actividad.**
**<CausedBy> java.lang.NullPointerException**

Cada vez que veas un java.lang.NullPointerException relacionado con una actividad de Recepción JMS, puedes estar seguro de que el problema está relacionado con la instalación de los controladores.

Si estamos hablando de tiempo de diseño, verás el mismo error cuando intentes iniciar una sesión de Ejecución o Depuración, pero adicionalmente verás el siguiente error cuando estés probando un Recurso de Conexión JMS, como puedes ver en la imagen a continuación:

Integración de TIBCO BW y EMS

Proceso de instalación

El proceso de instalación es bastante simple, pero necesitas acceso a una instalación de EMS o al menos una ubicación en disco con los clientes almacenados. Si ya tienes eso, solo necesitas ir a la siguiente ubicación:

 TIBCO_HOME/bw/<version>/bin

Donde TIBCO_HOME es la carpeta de instalación para la aplicación BusinessWorks, y version es el formato de versión menor (como 6.7, 2.7, 6.8, etc.).

En esta ubicación, ejecutarás el siguiente comando:

 ./bwinstall ems-driver

Esto comenzará y pedirá la ubicación de las bibliotecas del cliente, como puedes ver en la imagen a continuación:

Integración de TIBCO BW y EMS

Y después de eso, realizará el proceso de instalación y terminará con la salida BUILD SUCCESSFULL. Y después de ese punto, necesitarás reiniciar el Business Studio o los componentes de tiempo de ejecución (como AppNodes o bwagent) para que la configuración se aplique.

Si quieres profundizar más en el ecosistema TIBCO, consulta nuestra Guía completa de la plataforma de integración TIBCO donde cubrimos patrones, mejores prácticas y guía de producción.

Operadores de Kubernetes: 5 cosas que realmente necesitas saber

Operadores de Kubernetes: 5 cosas que realmente necesitas saber
Operadores de Kubernetes: 5 Cosas Que Realmente Necesitas Saber
Operadores de Kubernetes: 5 Cosas Que Realmente Necesitas Saber (Foto por Dan Lohmar en Unsplash)

Lectura relacionada: Controlador vs operador en Kubernetes: la diferencia real.

El Operador de Kubernetes ha sido la nueva norma para desplegar grandes cargas de trabajo en Kubernetes, pero como algunos de estos principios no se alinean inmediatamente con los conceptos principales de Kubernetes, generalmente genera un poco de confusión y dudas cuando necesitas usarlos o incluso crearlos.

¿Qué Son los Operadores de Kubernetes?

Los operadores son la forma de extender las capacidades de Kubernetes para gestionar grandes cargas de trabajo donde se relacionan diferentes opciones. En componentes con una arquitectura distribuida, como un sistema de monitoreo, un sistema de agregación de registros, o incluso un service mesh, puedes encontrar eso. Basado en las palabras de la documentación oficial de Kubernetes, los operadores se definen de la siguiente manera:

Los operadores son extensiones de software para Kubernetes que utilizan recursos personalizados para gestionar aplicaciones y sus componentes. Los operadores siguen los principios de Kubernetes, notablemente el bucle de control.

Su uso principal es para servicios estándar y no tanto para aplicaciones simples o cargas de trabajo de usuario, pero podría usarse en casos incluso para ese escenario.

¿Cómo Funciona el Operador de Kubernetes?

El concepto central detrás del Operador de Kubernetes es el concepto de extensión. Se basa en la definición y gestión de objetos personalizados de Kubernetes llamados Definición de Recursos Personalizados (CRDs) que permiten una descripción al estilo Kubernetes de nuevos conceptos que podrías necesitar para tus cargas de trabajo.

Algunos ejemplos de estos CRDs son el ServiceMonitor o PodMonitor que explicamos en publicaciones anteriores, por ejemplo, pero hay muchos más para agregar. Entonces, eso significa que ahora tienes un nuevo archivo YAML para definir tus objetos, y puedes usar las primitivas principales de Kubernetes para crearlos, editarlos o eliminarlos según sea necesario.

Entonces, para que estos componentes realicen cualquier trabajo, necesitas codificar algunos controladores específicos que traduzcan los cambios realizados en esos archivos YAML para alcanzar primitivas al estado del clúster.

Patrón de Operador de Kubernetes (https://github.com/cncf/tag-app-delivery/blob/eece8f7307f2970f46f100f51932db106db46968/operator-wg/whitepaper/Operator-WhitePaper_v1-0.md#foundation)

¿Cómo Gestionar los Operadores de Kubernetes?

El operador de Kubernetes se puede instalar como cualquier otra carga de trabajo de Kubernetes, por lo que dependiendo del caso puede distribuirse como un archivo YAML o un Helm Chart. Incluso puedes encontrar un repositorio compartido de operadores en OperatorsHub.

OperatorHub: Repositorio Central para Operadores de Kubernetes

Operador de Kubernetes vs. Helm Charts

Como ya se discutió, no son el mismo tipo de objeto que los Helm Charts porque los Helm Charts solo funcionan a nivel de despliegue haciendo el empaquetado y gestionando esos lanzamientos, pero los operadores van un paso más allá porque gestionan y controlan el ciclo de vida a nivel de tiempo de ejecución. Y como se comentó, Helm y los Operadores son compatibles; este es, por ejemplo, cómo funciona el Operador de Prometheus que tiene un Helm Chart para desplegarse, como puedes encontrar aquí.

Cómo Construir un Operador de Kubernetes

Si tu objetivo después de leer esto es crear un Operador de Kubernetes, necesitas saber que ya existen algunos marcos que harán tu vida más fácil en esa tarea.

Herramientas como Kopf, kubebuilder, metacontroller, o incluso el CNCF Operator Framework te proporcionarán las herramientas y las tareas cotidianas para comenzar a enfocarte en lo que tu operador necesita hacer, y ellos manejarán las principales tareas diarias por ti.

 Más Recursos Para Aprender sobre el Operador de Kubernetes

Si deseas aprender más sobre los Operadores de Kubernetes o el patrón de Operador, en ese caso, te recomiendo encarecidamente que mires el Libro Blanco del Operador de CNCF que puedes encontrar aquí.

Esto cubrirá todos los temas discutidos anteriormente con más detalle técnico e introducirá otros temas vitales, como la gestión del ciclo de vida de la seguridad o incluso las mejores prácticas.

Otros recursos interesantes son el recurso bibliográfico del propio Libro Blanco que voy a agregar aquí por si deseas ir directamente a la fuente:

  • Dobies, J., & Wood, J. (2020). Kubernetes Operators. O’Reilly.
  • Ibryam, B. (2019). Kubernetes Patterns. O’Reilly.
  • Operator Framework. (n.d.). Operator Capabilities. Operator Framework. Retrieved 11 2020, 24, from https://operatorframework.io/operator-capabilities/
  • Philips, B. (2016, 03 16). Introducing Operators: Putting Operational Knowledge into Software. CoreOS Blog. Retrieved 11 24, 2020, from https://coreos.com/blog/introducing-operators.html
  • Hausenblas, M & Schimanski, S. (2019). Programming Kubernetes. O’Reilly.

📚 Want to dive deeper into Kubernetes? This article is part of our comprehensive Kubernetes Architecture Patterns guide, where you’ll find all fundamental and advanced concepts explained step by step.

Principales 6 comandos de Kubectl y consejos de Kubectl

Principales 6 comandos de Kubectl y consejos de Kubectl
Los 6 mejores comandos de Kubectl y consejos de Kubectl

El comando kubectl puede ser el comando más utilizado que puedes escribir al trabajar con el ecosistema de Kubernetes. Como sabes, kubectl es la puerta de entrada a todo el mundo de Kubernetes, ya que prácticamente todas nuestras interacciones pasan por esa parte, a menos que estés utilizando un enfoque de CLI.

Entonces, basándonos en los principios de productividad, si puedes mejorar solo un 1% en la tarea que realizas más, la mejora global será masiva. Así que, veamos cómo podemos hacer eso aquí.

kubectl es un comando con muchas opciones diferentes que podrían ayudar a aumentar tu productividad mucho. Pero al mismo tiempo, como tiene tantas opciones, es bastante complejo conocerlas todas o estar al tanto de que hay una forma más rápida de hacer el trabajo, y por eso me gustaría agregar algunas opciones aquí para intentar ayudarte con este conjunto de consejos de kubectl.

Consejos de Comandos de Kubectl

Comencemos con los primeros comandos de kubectl que ayudan mucho a mejorar tu productividad:

kubectl explain <resource-object>

Este comando mostrará la referencia de la API para cualquier Objeto de Kubernetes, por lo que te ayudará a conocer la ortografía exacta de la opción que siempre escribes mal.

kubectl get <resource-object> —watch-output

La opción —watch-output añadida a cualquier comando de kubectl funcionará de la misma manera que el comando watch en sí, por lo que actualizará el mismo comando cada 2.0 segundos para ver la versión en tiempo real de ese comando y evitar que necesites escribirlo de nuevo o depender de un comando externo como watch

kubectl get events --sort-by=".lastTimestamp"

Este comando te ayudará cuando quieras ver los eventos en tu contexto actual, pero la principal diferencia es que ordenará la salida por la marca de tiempo de más reciente a más antiguo, por lo que evitarás tener que desplazarte para encontrar los últimos eventos.

kubectl logs --previous

Siempre hablamos de una de las necesidades de una Arquitectura de Agregación de Logs porque los logs son desechables, pero ¿qué pasa si quieres obtener los logs en un contenedor eliminado? Puedes usar la bandera --previous para acceder a los logs de un contenedor que se ha terminado recientemente. Esto no eliminará la necesidad de una técnica de agregación de logs, pero ayudará a solucionar problemas cuando Kubernetes comience a eliminar cosas y necesites saber qué sucedió.

kubectl create <object> <options> -o=yaml --dry-run=client

kubectl create nos permite crear un objeto de nuestra preferencia proporcionando los argumentos requeridos de manera imperativa, pero si añadimos la opción -o=yaml --dry-run=client, no obtendremos nuestro objeto creado. En su lugar, tendremos un archivo YAML que define ese objeto. Así que podemos modificarlo fácilmente a nuestras necesidades sin tener que hacerlo desde cero buscando en Google un ejemplo para comenzar.

kubectl top pods --all-namespaces --sort-by='memory'

Este comando alterará el orden estándar de top pods para mostrar los pods y los recursos que están consumiendo, y al mismo tiempo, ordenará esa salida por el uso de memoria. Así que, en entornos con muchos pods, proporcionará justo en la parte superior aquellos en los que deberías centrarte primero para optimizar los recursos de todo tu clúster.

Alias de Kubectl

Un paso más allá es simplificar esos comandos añadiendo un alias a esto. Como puedes ver, la mayoría de estos comandos son bastante largos ya que tienen muchas opciones, por lo que escribir cada una de estas opciones tomará un tiempo.

Entonces, si quieres ir un paso más allá en esta optimización, siempre puedes añadir un alias a ese comando para simplificarlo mucho. Y si quieres aprender más sobre esos alias, recomiendo encarecidamente el repositorio de GitHub de Ahmet Alp Balkan:

📚 Want to dive deeper into Kubernetes? This article is part of our comprehensive Kubernetes Architecture Patterns guide, where you’ll find all fundamental and advanced concepts explained step by step.

MinIO: Almacenamiento de Objetos Multinube

MinIO: Almacenamiento de Objetos Multinube

Todo el poder del almacenamiento de objetos en tu entorno de Kubernetes

MinIO: Almacenamiento de Objetos Multi Nube
MinIO: Almacenamiento de Objetos Multi Nube (Foto por Timelab Pro en Unsplash)

En este post, me gustaría presentarles MinIO, una verdadera solución de almacenamiento de objetos en la nube con todas las características que puedas imaginar e incluso algunas más. Probablemente estés al tanto del almacenamiento de objetos del servicio AWS S3 que surgió hace algunos años y de la mayoría de las alternativas en los principales proveedores de nube pública como Google o Azure.

¿Pero qué pasa con las nubes privadas? ¿Existe algo disponible que pueda proporcionar todos los beneficios del almacenamiento de objetos, pero sin necesidad de depender de un solo proveedor de nube? Y aún más importante que eso, en el presente y futuro, donde todas las empresas van a ser multi nube, ¿tenemos a nuestra disposición una herramienta que proporcione todas estas características pero que no nos obligue a tener un bloqueo de proveedor? Incluso algunos software, como Loki, te animan a usar una solución de almacenamiento de objetos.

¡La respuesta es sí! Y de eso se trata MinIO, y solo quiero usar sus propias palabras:

“MinIO ofrece almacenamiento de objetos de alto rendimiento, compatible con S3. Nativo de Kubernetes, MinIO es la única suite de almacenamiento de objetos disponible en cada nube pública, distribución de Kubernetes, la nube privada y el edge. MinIO es definido por software y es 100% de código abierto bajo GNU AGPL v3.”

Así que, como dije, todo lo que puedas imaginar e incluso más. Centrémonos en algunos puntos:

  • Nativo de Kubernetes: Puedes desplegarlo en cualquier distribución de Kubernetes de tu elección, ya sea pública o privada (o incluso en el edge).
  • 100% de código abierto bajo GNU AGPL v3, por lo que no hay bloqueo de proveedor.
  • Almacenamiento de objetos compatible con S3, lo que incluso simplifica la transición para clientes con un fuerte vínculo con el servicio AWS.
  • El alto rendimiento es la característica esencial.

Suena genial. ¡Probémoslo en nuestro entorno! Así que voy a instalar MinIO en mi entorno de rancher-desktop, y para hacerlo, voy a usar el operador que tienen disponible aquí:

Para poder instalar, la opción recomendada es usar krew, el gestor de plugins del que ya hablamos en otro artículo. Lo primero que necesitamos hacer es ejecutar el siguiente comando.

 kubectl minio init

Este comando desplegará el operador en el clúster como puedes ver en la imagen a continuación:

MinIO: Almacenamiento de Objetos Multinube

Una vez hecho y todos los componentes estén en funcionamiento, podemos lanzar las interfaces gráficas que nos ayudarán a crear el inquilino de almacenamiento. Para hacerlo, necesitamos ejecutar el siguiente comando:

 kubectl minio proxy -n minio-operator

Esto expondrá la interfaz interna que nos ayudará durante ese proceso. Se nos proporcionará un token JWT para poder iniciar sesión en la plataforma como puedes ver en la imagen a continuación:

MinIO: Almacenamiento de Objetos Multinube

Ahora necesitamos hacer clic en el botón que dice “Crear Inquilino” que nos proporcionará un menú de asistente para crear nuestro inquilino de almacenamiento de objetos MinIO:

MinIO: Almacenamiento de Objetos Multinube

En ese asistente podemos seleccionar varias propiedades dependiendo de nuestras necesidades, como esto es para mi escritorio rancher, intentaré mantener la configuración al mínimo como puedes ver aquí:

MinIO: Almacenamiento de Objetos Multinube

Sería útil si tuvieras el espacio de nombres creado de antemano para ser recuperado aquí. Además, debes tener en cuenta que solo puede haber un inquilino por espacio de nombres, por lo que necesitarás espacios de nombres adicionales para crear otros inquilinos.

Tan pronto como presiones crear, se te proporcionará una clave API y un secreto que necesitas almacenar (o descargar) para poder usar más tarde, y después de eso, el inquilino comenzará su despliegue. Después de unos minutos, tendrás todos tus componentes en funcionamiento, como puedes ver en la imagen a continuación:

MinIO: Almacenamiento de Objetos Multinube

Si vamos a nuestro console-svc, encontrarás la siguiente interfaz gráfica disponible:

MinIO: Almacenamiento de Objetos Multinube

Después de que las credenciales se descarguen en el paso anterior, ingresaremos a la consola de nuestro almacenamiento de objetos en la nube y podremos comenzar a crear nuestros buckets como puedes ver en la imagen a continuación:

MinIO: Almacenamiento de Objetos Multinube

En la pantalla de creación de un bucket, puedes ver varias opciones, como Versionado, Cuota y Bloqueo de Objetos, que dan una visión de las características y capacidades que tiene esta solución.

MinIO: Almacenamiento de Objetos Multinube

Y podemos comenzar a subir y descargar objetos a este nuevo bucket creado:

MinIO: Almacenamiento de Objetos Multinube

Espero que puedas ver esto como una opción para tus despliegues, especialmente cuando necesitas una opción de solución de almacenamiento de objetos para despliegues privados o simplemente como una alternativa a AWS S3.

📚 Want to dive deeper into Kubernetes? This article is part of our comprehensive Kubernetes Architecture Patterns guide, where you’ll find all fundamental and advanced concepts explained step by step.

Las 3 mejores opciones para implementar Loki escalable en Kubernetes

Las 3 mejores opciones para implementar Loki escalable en Kubernetes

Modelos de Despliegue para una Arquitectura Escalable de Agregación de Logs usando Loki

Desplegar un Loki escalable no es una tarea sencilla. Ya hemos hablado sobre Loki en publicaciones anteriores en el sitio, y se está volviendo cada vez más popular, y su uso se vuelve mucho más regular cada día. Es por eso que creo que tiene sentido incluir otra publicación sobre la Arquitectura de Loki.

Loki tiene varias ventajas que lo promueven como una opción predeterminada para desplegar una Pila de Agregación de Logs. Una de ellas es su escalabilidad porque puedes ver a través de diferentes modelos de despliegue cuántos componentes te gustaría desplegar y sus responsabilidades. Así que el objetivo del tema es mostrarte cómo desplegar una solución escalable de Loki y esto se basa en dos conceptos: componentes disponibles y cómo los agrupas.

Así que comenzaremos con los diferentes componentes:

  • ingester: responsable de escribir datos de logs en backends de almacenamiento a largo plazo (DynamoDB, S3, Cassandra, etc.) en la ruta de escritura y devolver datos de logs para consultas en memoria en la ruta de lectura.
  • distributor: responsable de manejar flujos entrantes por parte de los clientes. Es el primer paso en la ruta de escritura para los datos de logs.
  • query-frontend: servicio opcional que proporciona los puntos finales de la API del querier y puede usarse para acelerar la ruta de lectura.
  • querier: servicio que maneja consultas usando el lenguaje de consulta LogQL, obteniendo logs de los ingesters y del almacenamiento a largo plazo.
  • ruler: responsable de evaluar continuamente un conjunto de consultas configurables y realizar una acción basada en el resultado.

Luego puedes unirlos en diferentes grupos, y dependiendo del tamaño de estos grupos, tienes una topología de despliegue diferente, como se muestra a continuación:

Las 3 mejores opciones para implementar Loki escalable en Kubernetes
Modo de Despliegue Monolítico de Loki
  • Monolito: Como puedes imaginar, todos los componentes se ejecutan juntos en una sola instancia. Esta es la opción más simple y se recomienda como un punto de partida de 100 GB / día. Incluso puedes escalar este despliegue, pero escalará todos los componentes simultáneamente, y debería tener un estado de objeto compartido.
Las 3 mejores opciones para implementar Loki escalable en Kubernetes
Modo de Despliegue Escalable Simple de Loki
  • Modelo de Despliegue Escalable Simple: Este es el segundo nivel, y puede escalar hasta varios TB de logs por día. Consiste en dividir los componentes en dos perfiles diferentes: lectura y escritura.
Las 3 mejores opciones para implementar Loki escalable en Kubernetes
Modo de Despliegue de Microservicios de Loki
  • Microservicios: Eso significa que cada componente será gestionado de manera independiente, dándote todo el poder en tus manos para escalar cada uno de estos componentes por separado.

Definir el modelo de despliegue de cada instancia es muy fácil, y se basa en un solo parámetro llamado target. Así que dependiendo del valor del target seguirá uno de los modelos de despliegue anteriores:

  • all (por defecto): Se desplegará en modo monolítico.
  • write: Será la ruta de escritura en el modelo de despliegue escalable simple
  • read: Será el grupo de lectura en el modelo de despliegue escalable simple
  • ingester, distributor, query-frontend, query-scheduler, querier, index-gateway, ruler, compactor: Valores individuales para desplegar un solo componente para el modelo de despliegue de microservicios.

El argumento target ayudará para un tipo de despliegue on-premises. Aún así, si estás usando Helm para la instalación, Loki ya proporciona diferentes charts de helm para los otros modelos de despliegue:

Pero todos esos charts de helm se basan en el mismo principio comentado anteriormente sobre definir el rol de cada instancia usando el argumento target, como puedes ver en la imagen a continuación:

Las 3 mejores opciones para implementar Loki escalable en Kubernetes

📚 Want to dive deeper into Kubernetes? This article is part of our comprehensive Kubernetes Architecture Patterns guide, where you’ll find all fundamental and advanced concepts explained step by step.

Cómo habilitar los registros de acceso en las rutas predeterminadas de Openshift

white and gray spiral stairs

Pon algo de cerebro cuando una ruta no funciona como se espera, o tus consumidores no pueden acceder al servicio

Todos sabemos que Openshift es una distribución de Kubernetes excepcional y una de las más utilizadas, principalmente cuando se habla de implementaciones en la nube privada. Basado en la sólida reputación de Red Hat Enterprise Linux, Openshift pudo crear un producto sólido que se está convirtiendo casi en un estándar para la mayoría de las empresas.

Proporciona muchas extensiones del estilo de Kubernetes Vanilla, incluyendo algunos de los estándares de la industria de código abierto como Prometheus, Thanos y Grafana para el monitoreo de métricas o la pila ELK para la agregación de registros, pero también incluye sus extensiones como las Rutas de Openshift.

Las Rutas de Openshift fueron la solución inicial antes de que el concepto de Ingress fuera una realidad dentro del estándar. Ahora, también se implementa siguiendo ese patrón para mantener la compatibilidad. Está respaldado por HAProxy, uno de los proxies inversos más conocidos disponibles en la comunidad de código abierto.

Una de las partes complicadas por defecto es saber cómo depurar cuando una de tus rutas no funciona como se espera. La forma en que creas rutas es tan fácil que cualquiera puede hacerlo en unos pocos clics, y si todo funciona como se espera, eso es genial.

Pero si no es así, los problemas comienzan porque, por defecto, no obtienes ningún registro sobre lo que está sucediendo. Pero eso es lo que vamos a resolver aquí.

Primero, hablaremos un poco más sobre cómo se configura esto. Actualmente (versión 4.8 de Openshift), esto se implementa, como dije, usando HAProxy por defecto, así que si estás usando otra tecnología como ingresses como Istio o Nginx, este artículo no es para ti (pero no olvides dejar un comentario si un artículo similar sería de tu interés para que también pueda llevarlo al backlog 🙂 )

Desde la perspectiva de la implementación, esto se implementa usando el Marco de Operadores, por lo que el ingreso se despliega como un Operador, y está disponible en el espacio de nombres openshift-ingress-operator.

Cómo habilitar los registros de acceso en las rutas predeterminadas de Openshift
pods del operador de ingreso en el ecosistema de Openshift

Entonces, como esto es un operador, se han instalado varias Definiciones de Recursos Personalizados (CRD) para trabajar con esto, una de las más interesantes de este artículo. Este CRD es Controladores de Ingreso.

Cómo habilitar los registros de acceso en las rutas predeterminadas de Openshift
Instancias de Ingreso en el Ecosistema de Openshift

Por defecto, solo verás una instancia llamada default. Esta es la que incluye la configuración del ingreso que se está desplegando, por lo que necesitamos agregar aquí una configuración adicional para tener también los registros.

Cómo habilitar los registros de acceso en las rutas predeterminadas de Openshift
Archivo YAML del controlador de ingreso

El fragmento que necesitamos es el que se muestra a continuación bajo el parámetro spec que comienza la definición de la especificación del IngressController en sí:

   logging:
    access:
      destination:
        type: Container
      httpLogFormat: >-
        log_source="haproxy-default" log_type="http" c_ip="%ci" c_port="%cp"
        req_date="%tr" fe_name_transport="%ft" be_name="%b" server_name="%s"
        res_time="%TR" tot_wait_q="%Tw" Tc="%Tc" Tr="%Tr" Ta="%Ta"
        status_code="%ST" bytes_read="%B" bytes_uploaded="%U"
        captrd_req_cookie="%CC" captrd_res_cookie="%CS" term_state="%tsc"
        actconn="%ac" feconn="%fc" beconn="%bc" srv_conn="%sc" retries="%rc"
        srv_queue="%sq" backend_queue="%bq" captrd_req_headers="%hr"
        captrd_res_headers="%hs" http_request="%r"
 

Esto hará que se despliegue otro contenedor en los pods del enrutador en el espacio de nombres openshift-ingress siguiendo el patrón sidecar llamado logs.

Cómo habilitar los registros de acceso en las rutas predeterminadas de Openshift
Pods del enrutador en la instalación de Openshift

Este contenedor imprimirá los registros de las solicitudes que llegan al componente de ingreso, por lo que la próxima vez que tu consumidor no pueda llamar a tu servicio, podrás ver las solicitudes entrantes con todos sus metadatos y saber al menos qué está haciendo mal:

Cómo habilitar los registros de acceso en las rutas predeterminadas de Openshift
Registros de acceso de la Ruta de Openshift

Como puedes ver, ¡simple y fácil! Si ya no lo necesitas, puedes eliminar la configuración nuevamente y guardarla, y la nueva versión se implementará y volverá a la normalidad.

📚 Want to dive deeper into Kubernetes? This article is part of our comprehensive Kubernetes Architecture Patterns guide, where you’ll find all fundamental and advanced concepts explained step by step.

Cómo mejorar la productividad en el desarrollo de cargas de trabajo de Kubernetes

timelapse photo of highway during golden hour

La telepresencia es la forma de reducir el tiempo entre tus líneas de código y una carga de trabajo nativa de la nube en ejecución.

foto de lapso de tiempo de la autopista durante la hora dorada
Foto de Joey Kyber en Unsplash

Todos sabemos cómo las cargas de trabajo nativas de la nube y Kubernetes han cambiado la forma en que hacemos las cosas. Hay muchos beneficios que vienen con el efecto de la contenedorización y las plataformas de orquestación como Kubernetes, y hemos discutido mucho sobre ello: escalabilidad, autocuración, autodescubrimiento, resiliencia, y así sucesivamente.

Pero se han planteado algunos desafíos, la mayoría de ellos en el aspecto operativo en el que tenemos muchos proyectos enfocados en abordar, pero generalmente olvidamos lo que el embajador ha definido como el “ciclo de desarrollo interno”.

El “ciclo de desarrollo interno” es el flujo de trabajo productivo que cada desarrollador sigue al trabajar en una nueva aplicación, servicio o componente. Este flujo iterativo es donde codificamos, probamos lo que hemos codificado y arreglamos lo que no funciona o mejoramos lo que ya tenemos.

Este flujo ha existido desde el principio de los tiempos; no importa si estabas codificando en C usando la biblioteca STD o COBOL a principios de 1980 o haciendo nodejs con los últimos marcos y bibliotecas a tu disposición.

Hemos visto movimientos hacia hacer este ciclo interno más efectivo, especialmente en el desarrollo front-end. Tenemos muchas opciones para ver el último cambio que hemos hecho en el código, solo guardando el archivo. Pero por primera vez, cuando el movimiento hacia una plataforma basada en contenedores, este flujo hace que los desarrolladores sean menos productivos.

La razón principal es que el número de tareas que un desarrollador necesita hacer ha aumentado. Imagina este conjunto de pasos que necesitamos realizar:

  • Construir la aplicación
  • Construir la imagen del contenedor
  • Desplegar la imagen del contenedor en Kubernetes

Estas acciones no son tan rápidas como probar tus cambios localmente, haciendo que los desarrolladores sean menos productivos que antes, que es lo que el proyecto “telepresencia” está tratando de resolver.

La telepresencia es un proyecto incubador de la CNCF que ha centrado mucha atención recientemente porque se ha incluido OOTB en las últimas versiones del componente Docker Desktop. Basado en sus propias palabras, esta es la definición del proyecto de telepresencia:

La telepresencia es una herramienta de código abierto que permite a los desarrolladores codificar y probar microservicios localmente contra un clúster de Kubernetes remoto. La telepresencia facilita flujos de trabajo de desarrollo más eficientes aliviando la necesidad de preocuparse por otras dependencias de servicio.

Ok, entonces, ¿cómo podemos empezar? Vamos a sumergirnos juntos. Lo primero que necesitamos hacer es instalar la telepresencia en nuestro clúster de Kubernetes:

Nota: También hay una forma de instalar telepresencia usando Helm en tu clúster siguiendo estos pasos:

helm repo add datawire  https://app.getambassador.io
helm repo update
kubectl create namespace ambassador
helm install traffic-manager --namespace ambassador datawire/telepresence

Ahora crearé un contenedor simple que alojará una aplicación Golang que expone un servicio REST simple y lo haré más accesible; seguiré el tutorial que está disponible a continuación; tú también puedes hacerlo.

Una vez que tengamos nuestra aplicación golang lista, vamos a generar el contenedor a partir de ella, usando el siguiente Dockerfile:

FROM golang:latest

RUN apt-get update
RUN apt-get upgrade -y

ENV GOBIN /go/bin

WORKDIR /app

COPY *.go ./
RUN go env -w GO111MODULE=off
RUN go get .
RUN go build -o /go-rest
EXPOSE 8080
CMD [ "/go-rest" ]

Luego, una vez que tengamos la aplicación, la subiremos al servidor de Kubernetes y la ejecutaremos como un despliegue, como puedes ver en la imagen a continuación:

kubectl create deployment rest-service --image=quay.io/alexandrev/go-test  --port=8080
kubectl expose deploy/rest-service

Una vez que tengamos eso, es el momento de comenzar a ejecutar la telepresencia, y comenzaremos a conectarnos al clúster usando el siguiente comando telepresence connect, y mostrará una salida como esta:

Cómo mejorar la productividad en el desarrollo de cargas de trabajo de Kubernetes

Luego vamos a listar los puntos finales disponibles para interceptar con el comando telepresence list y veremos nuestro servicio-rest que hemos expuesto antes:

Cómo mejorar la productividad en el desarrollo de cargas de trabajo de Kubernetes

Ahora, ejecutaremos el interceptor específico, pero antes de eso, vamos a hacer el truco para que podamos conectarlo a nuestro Visual Studio Code. Generaremos un archivo launch.json en Visual Studio Code con el siguiente contenido:

{
    // Usa IntelliSense para aprender sobre posibles atributos.
    // Pasa el ratón para ver descripciones de atributos existentes.
    // Para más información, visita: https://go.microsoft.com/fwlink/?linkid=830387
    "version": "0.2.0",
    "configurations": [
        {
            "name": "Lanzar con archivo env",
            "type": "go",
            "request": "launch",
            "mode": "debug",
            "program": "1",
            "envFile": "NULL/go-debug.env"
           }
    ]
}

La parte interesante aquí es el argumento envFile que apunta a un archivo inexistente go-debug.env en la misma carpeta, por lo que necesitamos asegurarnos de que generamos ese archivo cuando hacemos la intercepción. Así que usaremos el siguiente comando:

telepresence intercept rest-service --port 8080:8080 --env-file /Users/avazquez/Data/Projects/GitHub/rest-golang/go-debug.env

Y ahora, podemos comenzar nuestra sesión de depuración en Visual Studio Code y tal vez agregar un punto de interrupción y algunas líneas, como puedes ver en la imagen a continuación:

Cómo mejorar la productividad en el desarrollo de cargas de trabajo de Kubernetes

Entonces, ahora, si golpeamos el pod en Kubernetes, veremos cómo se alcanza el punto de interrupción como si estuviéramos en una sesión de depuración local.

Cómo mejorar la productividad en el desarrollo de cargas de trabajo de Kubernetes

Eso significa que podemos inspeccionar variables y todo, cambiar el código o hacer lo que necesitemos para acelerar nuestro desarrollo!

📚 Want to dive deeper into Kubernetes? This article is part of our comprehensive Kubernetes Architecture Patterns guide, where you’ll find all fundamental and advanced concepts explained step by step.

ServiceMonitor y PodMonitor de Prometheus: ¡No te pierdas los nuevos conceptos!

black flat screen tv turned on near black and gray audio component

Descubre las diferencias entre dos de los CRDs más utilizados del Operador Prometheus y cómo usar cada uno de ellos.

Conceptos de Prometheus: ServiceMonitor y PodMonitor

Foto de Ibrahim Boran en Unsplash

ServiceMonitor y PodMonitor son términos que comenzarás a ver más a menudo cuando se hable de usar Prometheus. Hemos cubierto mucho sobre Prometheus en artículos anteriores. Es una de las principales referencias cuando hablamos de monitoreo en un entorno nativo de la nube y está especialmente enfocado en el ecosistema de Kubernetes.

Prometheus tiene un nuevo modelo de implementación bajo el Marco del Operador de Kubernetes en tiempos recientes. Eso ha generado varios cambios en términos de recursos y cómo configuramos varios aspectos del monitoreo de nuestras cargas de trabajo. Algunos de estos conceptos ahora se gestionan como Definición de Recurso Personalizado (CRD) que se incluyen para simplificar la configuración del sistema y estar más alineados con las capacidades de la propia plataforma de Kubernetes. Esto es genial pero, al mismo tiempo, cambia cómo necesitamos usar esta excelente herramienta de monitoreo para cargas de trabajo nativas de la nube.

Hoy, cubriremos dos de estos nuevos CRDs, uno de los más relevantes: ServiceMonitor y PodMonitor. Estos son los nuevos objetos que especifican los recursos que estarán bajo el alcance de monitoreo para la plataforma, y cada uno de ellos cubre un tipo diferente de objeto, como puedes imaginar: Servicios y Pods.

Cada uno de ellos tiene su archivo de definición con sus campos y metadatos particulares, y para destacarlos, presentaré un ejemplo para cada uno de ellos a continuación:

Service Monitor

apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  labels:
    serviceMonitorSelector: prometheus
  name: prometheus
  namespace: prometheus
spec:
  endpoints:
  - interval: 30s
    targetPort: 9090
    path: /metrics
  namespaceSelector:
    matchNames:
    - prometheus
  selector:
    matchLabels:
      operated-prometheus: "true"

Pod Monitor

apiVersion: monitoring.coreos.com/v1
kind: PodMonitor
metadata:
  name: front-end
  labels:
    name: front-end
spec:
  namespaceSelector:
    matchNames:
      - sock-shop
  selector:
    matchLabels:
      name: front-end
  podMetricsEndpoints:
  - targetPort: 8079

Como puedes ver, las definiciones de los componentes son muy similares y muy intuitivas, enfocándose en el selector para detectar qué pods o servicios debemos monitorear y algunos datos sobre el objetivo específico del monitoreo, para que Prometheus sepa cómo extraerlos.

Si deseas echar un vistazo más en detalle a cualquier opción que puedas configurar en este CRD, te recomendaría que eches un vistazo a esta URL que incluye una documentación detallada campo por campo de los CRDs más comunes:

Estos componentes pertenecerán a la definición de tus cargas de trabajo, lo que significa que la creación y el mantenimiento de estos objetos serán responsabilidad de los desarrolladores de la aplicación.

Eso es genial por varias razones:

  • Incluirá el aspecto de Monitoreo del propio componente, por lo que nunca olvidarás agregar la configuración de un componente específico. Eso significa que se puede incluir en los archivos YAML duplicados o en el Helm Chart o en recursos de Kustomize como otro recurso necesario.
  • Descentralizará la configuración de monitoreo haciéndola más ágil, y progresará a medida que lo hagan los componentes de software.
  • Reducirá el impacto en otros componentes monitoreados ya que no hay necesidad de actuar en ningún archivo o recurso estándar, por lo que cualquier carga de trabajo diferente continuará funcionando como se espera.

Ambos objetos son muy similares en sus propósitos ya que ambos extraen todos los endpoints que coinciden con el selector que agregamos. Entonces, ¿en qué casos debería usar uno u otro?

La respuesta será sencilla. Por defecto, optarás por un ServiceMonitor porque proporcionará las métricas del propio servicio y de cada uno de los endpoints que tiene el servicio, por lo que cada uno de los pods que están implementando el servicio será descubierto y extraído como parte de esta acción.

Entonces, ¿en qué casos debería usar PodMonitor? Donde la carga de trabajo que estás tratando de monitorear no actúa detrás de un servicio, por lo que al no haber un servicio definido, no puedes usar ServiceMonitor. ¿Quieres algunos ejemplos de eso? ¡Traigamos algunos!

  • Servicios que interactúan usando otros protocolos que no son basados en HTTP, como Kafka, SQS/SNS, JMS, o similares.
  • Componentes como CronJobs, DaemonSets, o que no exponen ningún modelo de conexión entrante.

Así que espero que este artículo te ayude a entender la principal diferencia entre esos objetos y profundizar un poco más en cómo funcionan los nuevos recursos del Marco del Operador Prometheus. Continuaremos cubriendo otros aspectos en próximos artículos.

📚 Want to dive deeper into Kubernetes? This article is part of our comprehensive Kubernetes Architecture Patterns guide, where you’ll find all fundamental and advanced concepts explained step by step.

Escalar a Cero y Desde Cero en tu Clúster de Kubernetes

brown and beige weighing scale

Llevando la Experiencia Serverless a tu Clúster de Kubernetes

Escalar a Cero y Desde Cero en tu Clúster de Kubernetes

Foto de Piret Ilver en Unsplash

Serverless siempre ha sido considerado el siguiente paso en el viaje a la nube. Sabes a lo que me refiero: comienzas desde tu VM en las instalaciones, luego te mueves a tener contenedores en una plataforma PaaS, y luego intentas encontrar tu próxima parada en este viaje que es serverless.

Escalar a Cero y Desde Cero en tu Clúster de Kubernetes
Evolución tecnológica definida basada en la perspectiva de abstracción de infraestructura

Serverless es la idea de olvidarse de la infraestructura y centrarse solo en tus aplicaciones. No hay necesidad de preocuparse por dónde se ejecutará o la gestión de la infraestructura subyacente. Serverless comenzó como un sinónimo del paradigma de Función como Servicio (FaaS). Fue popularizado primero por las funciones de Amazon Lambda y luego por todos los principales proveedores de nube.

Comenzó como una alternativa al enfoque de contenedores que probablemente requiere muchas habilidades técnicas para gestionar y ejecutar a escala de producción, pero este ya no es el caso.

Hemos visto cómo el enfoque serverless ha llegado a cualquier plataforma a pesar de este punto de partida. Siguiendo los mismos principios, tenemos diferentes plataformas cuyo enfoque es abstraer todos los aspectos técnicos para la parte operativa y proporcionar una plataforma donde puedas poner tu lógica en ejecución. Prácticamente cada plataforma SaaS cubre este enfoque, pero me gustaría destacar algunos ejemplos para aclarar:

  • netlify es una plataforma que te permite desplegar tu aplicación web sin necesidad de gestionar nada más que el código necesario para ejecutarla.
  • TIBCO Cloud Integration es una solución iPaaS que proporciona todos los recursos técnicos que podrías necesitar para que puedas centrarte en desplegar tus servicios de integración.

Pero yendo más allá, prácticamente cada servicio proporcionado por las principales plataformas en la nube como Azure, AWS o GCP sigue el mismo principio. La mayoría de ellos (mensajería, aprendizaje automático, almacenamiento, etc.) abstraen toda la infraestructura subyacente para que puedas centrarte en el servicio real.

Volviendo al ecosistema de Kubernetes, tenemos dos capas diferentes de ese enfoque. La principal es el servicio de Kubernetes gestionado que todas las grandes plataformas proporcionan donde toda la gestión de Kubernetes (nodos maestros, componentes internos de Kubernetes) son transparentes para ti y te centras todo en los trabajadores. Y el segundo nivel es lo que puedes obtener en el mundo de AWS con la arquitectura tipo EKS + Fargate donde ni siquiera existen los nodos de trabajo, tienes tus pods que se desplegarán en una máquina que pertenece a tu clúster pero no necesitas preocuparte por ello, ni gestionar nada relacionado con eso.

Así que, como hemos visto, el enfoque serverless está llegando a todas las áreas, pero este no es el alcance de este artículo. La idea aquí es tratar de centrarse en serverless como sinónimo de Función como Servicio (FaaS) y cómo podemos llevar la experiencia FaaS a nuestro ecosistema productivo de K8S. Pero comencemos con las preguntas iniciales:

¿Por qué querríamos hacer eso?

Esta es la cosa más emocionante de preguntar: ¿cuáles son los beneficios que proporciona este enfoque? Función como Servicio sigue el enfoque de escala cero. Eso significa que la función no se carga si no se está ejecutando, y esto es importante, especialmente cuando eres responsable de tu infraestructura o al menos estás pagando por ella.

Imagina un microservicio normal escrito en cualquier tecnología, la cantidad de recursos que puede usar depende de su carga, pero incluso sin ninguna carga, necesitas algunos recursos para mantenerlo en funcionamiento; principalmente, estamos hablando de memoria que necesitas mantener en uso. La cantidad real dependerá de la tecnología y del desarrollo en sí, pero puede moverse de algunos MB a algunos cientos. Si consideramos todos los microservicios que una empresa significativa puede tener, obtendrás una diferencia de varios GB que estás pagando y que no están proporcionando ningún valor.

Pero más allá de la gestión de infraestructura, este enfoque también juega muy bien con otro de los últimos enfoques arquitectónicos, la Aplicación Basada en Eventos (EDA), porque podemos tener servicios que están dormidos solo esperando el evento correcto para despertarlos y comenzar a procesar.

Entonces, en resumen, el enfoque serverless te ayuda a obtener tu sueño de infraestructura optimizada y habilitar diferentes patrones también de manera eficiente. Pero, ¿qué pasa si ya poseo la infraestructura? Será lo mismo porque ejecutarás más servicios en la misma infraestructura, por lo que aún obtendrás el uso optimizado de tu infraestructura actual.

¿Qué necesitamos para habilitar eso?

Lo primero que necesitamos saber es que no todas las tecnologías o marcos son adecuados para ejecutarse en este enfoque. Eso se debe a que necesitas cumplir con algunos requisitos para poder hacerlo como un enfoque exitoso, como se muestra a continuación:

  • Inicio Rápido: Si tu lógica no está cargada antes de que una solicitud llegue al servicio, necesitarás asegurarte de que la lógica pueda cargarse rápidamente para evitar impactar al consumidor del servicio. Eso significa que necesitarás una tecnología que pueda cargarse en una pequeña cantidad de tiempo, generalmente hablando en el rango de microsegundos.
  • Sin Estado: Como tu lógica no se va a cargar en un modo continuo, no es adecuada para servicios con estado.
  • Descarte: Similar al punto anterior, debe estar listo para un apagado elegante de manera robusta.

¿Cómo hacemos eso?

Varios marcos nos permiten obtener todos esos beneficios que podemos incorporar en nuestro ecosistema de Kubernetes, como los siguientes:

  • KNative: Este es el marco que la Fundación CNCF apoya y se está incluyendo por defecto en muchas distribuciones de Kubernetes como Red Hat Openshift Platform.
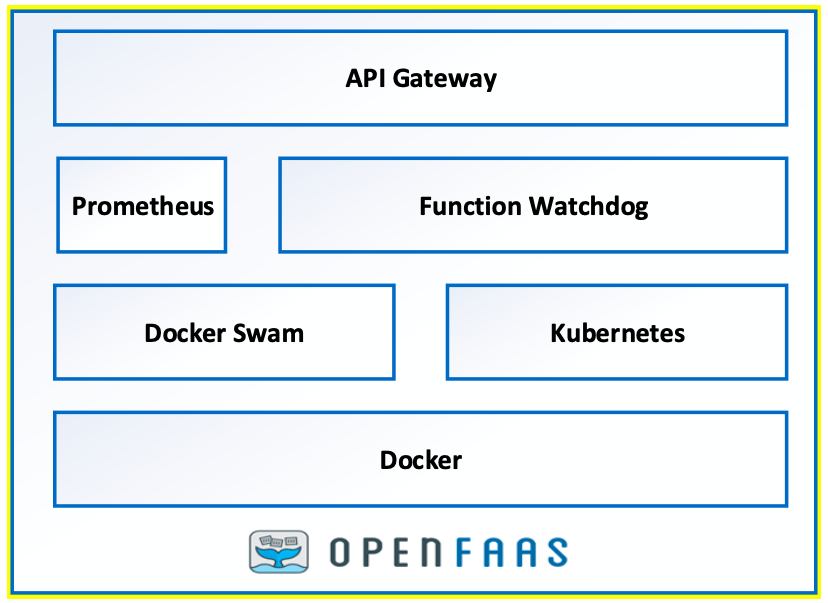
  • OpenFaaS: Este es un marco muy utilizado creado por Alex Ellis que apoya la misma idea.

Es cierto que hay otras alternativas como Apache OpenWhisk, Kubeless o Fission, pero son menos utilizadas en el mundo actual y principalmente la mayoría de las alternativas han sido elegidas entre OpenFaaS y KNative, pero si quieres leer más sobre otras alternativas te dejaré un artículo sobre la CNCF cubriéndolas para que puedas echar un vistazo por ti mismo:

📚 Want to dive deeper into Kubernetes? This article is part of our comprehensive Kubernetes Architecture Patterns guide, where you’ll find all fundamental and advanced concepts explained step by step.