TIBFAQS: Mejorando el Tiempo de Respuesta de tu API SOAP de TIBCO BW en Grandes Cargas Útiles al Usar Apache Commons

TIBFAQS: Mejorando el Tiempo de Respuesta de tu API SOAP de TIBCO BW en Grandes Cargas Útiles al Usar Apache Commons

Descubre cómo ajustar tus servicios SOAP para que sean eficientes para solicitudes de carga masiva 

TIBFAQS: Mejorando el Tiempo de Respuesta de tu API SOAP de TIBCO BW en Grandes Cargas Útiles al Usar Apache Commons
Foto de Markus Spiske en Unsplash

Todos sabemos que cuando estamos implementando una API, necesitamos diseñar cuidadosamente el tamaño que podemos manejar como el máximo tamaño de solicitud. Por ejemplo, deberías saber que para una solicitud en línea, el límite superior habitual es de 1 MB, todo lo que supere eso deberíamos poder manejarlo de manera diferente (las opciones para manejarlo pueden ser dividir las solicitudes o usar otros protocolos en lugar de HTTP para manejar este tipo de cargas). Pero luego la vida real viene a enfrentarnos allí.

No siempre es posible ceñirse al plan. No siempre somos nosotros los que tomamos esa decisión. Y podemos argumentar todo lo que queramos que esto no es una buena idea y eso está bien, pero al mismo tiempo, necesitamos hacer algo que funcione.

Por defecto, cuando estamos exponiendo un Servicio SOAP en TIBCO BusinessWorks, se basa en bibliotecas de terceros para gestionar la solicitud, analizarla y ayudarnos a acceder al contenido de las solicitudes. Algunas de ellas provienen de la Fundación Apache, y de la que vamos a hablar es Apache Commons.

Cuando estamos enviando una solicitud grande a nuestro servicio SOAP, en mi caso, esta es una solicitud SOAP de 11 MB a mi sistema, y empiezo a ver el siguiente comportamiento:

TIBFAQS: Mejorando el Tiempo de Respuesta de tu API SOAP de TIBCO BW en Grandes Cargas Útiles al Usar Apache Commons
  • El servicio no está respondiendo a mi consumidor.
  • Puedo ver un uso significativo del hilo del Conector HTTP manejando la solicitud antes de enviarla al servicio real.
  • La CPU y la memoria están aumentando mucho.

Entonces, ¿cómo podemos mejorar eso? Lo primero es profundizar más en los detalles sobre ese uso extensivo de la CPU. Por ejemplo, si vamos al seguimiento de pila que los hilos del Conector HTTP están ejecutando, puedes ver el siguiente seguimiento de pila:

TIBFAQS: Mejorando el Tiempo de Respuesta de tu API SOAP de TIBCO BW en Grandes Cargas Útiles al Usar Apache Commons

Puedes obtener esa información de varias fuentes:

  • Una es usar el JVisual VM e ir a los detalles del snapshot en las muestras como lo hice yo.
  • También puedes obtener un volcado de hilos y usar herramientas como https://fastthread.io/index.jsp para visualizarlo gráficamente.

Aquí podemos ver que estamos atascados en el método de registro. Y eso es extraño, ¿por qué estoy registrando estas solicitudes si no estoy haciendo eso en la configuración de BusinessWorks? La respuesta es bastante simple: las bibliotecas de Apache tienen su propio sistema de registro que no se ve afectado por la configuración de logback que usa BusinessWorks.

Entonces, podemos desactivar eso usando la siguiente propiedad JVM:

-Dorg.apache.commons.logging.Log=org.apache.commons.logging.impl.NoOpLog

El tiempo de respuesta ha mejorado de 120 segundos para 11 MB a menos de 3 segundos, incluyendo toda la lógica que el servicio estaba haciendo. Bastante impresionante, ¿verdad?

TIBFAQS: Mejorando el Tiempo de Respuesta de tu API SOAP de TIBCO BW en Grandes Cargas Útiles al Usar Apache Commons

Resumen

Espero que encuentres esto interesante, y si eres uno de los que enfrenta este problema ahora, tienes información para no detenerte por este. Si deseas enviar tus preguntas, no dudes en usar una de las siguientes opciones:

  • Twitter: Puedes enviarme una mención a @alexandrev en Twitter o un DM o incluso solo usando el hashtag #TIBFAQS que monitorearé.
  • Email: Puedes enviarme un correo electrónico a alexandre.vazquez en gmail.com con tu pregunta.
  • Instagram: Puedes enviarme un DM en Instagram a @alexandrev
TIBFAQS: Mejorando el Tiempo de Respuesta de tu API SOAP de TIBCO BW en Grandes Cargas Útiles al Usar Apache Commons

Para una visión completa del ecosistema TIBCO, consulta nuestra Guía de la plataforma de integración TIBCO.
¿Cómo desarrollar una API de manera eficiente?

¿Cómo desarrollar una API de manera eficiente?

Aprende algunos consejos sobre cómo crear tu API de manera eficiente y lidiar con el trabajo real simultáneamente.

¿Cómo desarrollar una API de manera eficiente?
Foto de Edho Pratama en Unsplash

Al crear una API para exponer una capacidad o integrar diferentes sistemas, hay principalmente dos formas de hacerlo: enfoque de Contrato-Primero o enfoque de Contrato-Último. La diferencia radica en la metodología que seguirás para crear la API.

En un enfoque de contrato-primero, la definición del contrato es el punto de partida. No importa qué lenguaje o tecnología estés utilizando. Esta realidad ha sido la misma desde el comienzo del sistema distribuido en tiempos de RMI y CORBA y continúa siendo la misma en los tiempos extraordinarios de gRPC y GraphQL.

Comienzas con la definición del contrato entre ambas partes: la que expone la capacidad y el consumidor inicial de la información. Eso implica la definición de varios aspectos de él:

  • Propósito de las operaciones.
  • Campos que tiene cada operación.
  • Información de retorno dependiendo de cada escenario.
  • Información de errores reportados, y así sucesivamente.

Después de eso, comenzarás a diseñar la API en sí y la implementación para cumplir con la definición acordada entre las partes.

Este enfoque tiene varias ventajas y desventajas, pero hoy en día es la forma más «aceptable» de desarrollar API. Como ventajas podemos comentar las siguientes:

  • Reducción de Actividades de Retrabajo: Al comenzar definiendo el contrato, puedes validar rápidamente que todas las partes están de acuerdo con el contrato antes de escribir cualquier trabajo de implementación. Eso evitaría cualquier actividad de recodificación o retrabajo debido a un malentendido o simplemente adaptación de las expectativas y se volvería más eficiente.
  • Separación de Funciones: También proporcionará la separación de funciones para ambas partes, el proveedor y los consumidores. Porque tan pronto como tengas el contrato, ambos equipos pueden comenzar a trabajar en eso. Incluso puedes proporcionar un simulacro para que el consumidor pruebe cualquier escenario rápidamente sin la necesidad de esperar a que se cree el servicio real.

Pero el enfoque de Contrato-Primero tiene algunos requisitos o suposiciones para tener éxito que no son muy fáciles de cumplir en un escenario del mundo real. Esta situación es esperada. Hay muchas metodologías, consejos o recomendaciones que aprendes cuando estás estudiando que no son aplicables en la vida real. Para validar ese comentario, permíteme hacerte una pregunta:

¿Creaste una API y la interfaz que creaste fue 100% la misma que tenías al final?

La respuesta a esa pregunta en mi caso es «No, nunca». Y puedes pensar que soy un mal diseñador de API, y podrías tener razón. Estoy seguro de que la mayoría de las personas que leen este artículo definirían sus contratos mucho mejor que yo, pero ese no es el punto. Porque cuando estamos en la fase de implementación, generalmente detectamos algo que no pensamos en la fase de diseño, o cuando intentamos hacer un diseño de bajo nivel, hay otros conceptos que no contemplamos en el punto que hace que otra solución sea la más adecuada para el escenario, por lo que impactarás la API, y eso tiene un costo.

Es posible que mitiges ese riesgo simplemente dedicando más tiempo a la fase de definición del contrato para asegurarte de que nada esté bien considerado o incluso crear algunos prototipos para garantizar que la API generada sea la final. Pero si haces esto, solo estás reduciendo la probabilidad de que esto suceda, nunca eliminándola, y al mismo tiempo, estás reduciendo los beneficios del enfoque.

Uno de los puntos críticos que comentamos anteriormente fue la eficiencia. Supongamos que pensamos en la eficiencia ahora cuando dedicarás más tiempo a esa fase. Eso significa que será menos eficiente. También comentamos sobre lo grandioso de hacer la separación de funciones: pero en este caso, mientras se extiende el tiempo de creación de la interfaz, también se extiende el tiempo que ambos equipos necesitan esperar hasta que puedan trabajar en sus partes.

Pero implementar el otro enfoque no proporcionará mucho beneficio. Puede llevar a un trabajo aún más costoso porque no obtendrás validación para el cliente hasta que la API esté implementada. Y nuevamente, otra pregunta:

¿Alguna vez compartiste algo con tu cliente por primera vez y no pidieron ningún cambio?

Nuevamente, la respuesta es la misma: «No, nunca». Y ese costo siempre será mayor que el que se habla del cambio en la definición, porque como sabes, el cambio es mucho más costoso cuanto más tarde lo detectes en el ciclo de desarrollo, y no es un aumento lineal. Es mucho más cercano a un aumento exponencial.

Entonces, ¿cuál es mi recomendación aquí? Sigue el enfoque de contrato-primero y acepta la vida real. Así que haz tu mejor esfuerzo para definir la API y tener un acuerdo entre las partes y si detectas algo que pueda impactar la API, notifícalo lo antes posible a las partes. Al final, esto no es más que un enfoque interactivo también para la definición de la API, y no hay nada de malo en ello.

Seamos honestos, no hay una bala de plata que proporcione el camino verde en tu trabajo diario, y eso es lo grandioso de hacerlo y por qué lo disfrutamos tanto. Porque en cada una de nuestras decisiones de trabajo, como sucede en cualquier otro aspecto de la vida, hay tantos aspectos, tantas situaciones, tantos detalles que siempre impactan la increíble y hermosa metodología que puedes ver en un artículo, un documento, una clase o un tweet.

Desenredando las Políticas de Reclamación para Volúmenes Persistentes en Kubernetes

Desenredando las Políticas de Reclamación para Volúmenes Persistentes en Kubernetes

Descubre cómo la política puede afectar cómo se gestionan tus datos dentro del Clúster de Kubernetes

Como sabes, todo está bien en Kubernetes hasta que te enfrentas a una carga de trabajo con estado y necesitas gestionar sus datos. Todas las potentes capacidades que Kubernetes aporta al juego enfrentan muchos desafíos cuando hablamos de servicios con estado que requieren muchos datos. La mayoría de los desafíos tienen una solución hoy en día. Es por eso que muchas cargas de trabajo con estado, como bases de datos y otros sistemas de backend, también requieren mucho conocimiento sobre cómo definir varias cosas. Una de ellas es la política de retención del volumen persistente. Primero, definamos qué es la Política de Reclamación, y para hacerlo, usaré la definición oficial de la documentación:
Cuando un usuario ha terminado con su volumen, puede eliminar los objetos PVC de la API que permite la reclamación del recurso. La política de reclamación para un PersistentVolume le dice al clúster qué hacer con el volumen después de que ha sido liberado de su reclamación. Actualmente, los volúmenes pueden ser Retenidos, Reciclados o Eliminados.
Entonces, como puedes ver, tenemos tres opciones: Retener, Reciclar o Eliminar. Veamos cuál es el comportamiento de cada una de ellas.

Retener

Eso significa que los datos seguirán allí incluso si la reclamación ha sido eliminada. Todas estas políticas se aplican cuando el PVC original es eliminado. Antes de esa situación, los datos siempre permanecerán sin importar qué política usemos. Entonces, retener significa que incluso si eliminamos el PVC, los datos seguirán allí, y se almacenarán de manera que ningún otro PVC pueda reclamar esos datos. Solo un administrador puede hacerlo con el siguiente flujo:
  1. Eliminar el PersistentVolume.
  2. Limpiar manualmente los datos en el activo de almacenamiento asociado según corresponda.
  3. Eliminar manualmente el activo de almacenamiento asociado.

Eliminar

Eso significa que tan pronto como eliminemos el PVC, el PV y los datos serán liberados. Esto simplificará la tarea de limpieza y mantenimiento de tus volúmenes, pero al mismo tiempo, aumenta la posibilidad de que haya alguna pérdida de datos debido a un comportamiento inesperado. Como siempre, este es un compromiso que necesitas hacer. Siempre necesitamos recordarte que si intentas eliminar un PVC en uso activo por un Pod, el PVC no se elimina inmediatamente. La eliminación del PVC se pospone hasta que el PVC ya no sea utilizado activamente por ningún Pod para asegurar que no se pierdan datos, al menos cuando algún componente todavía está vinculado a él. En la misma política, algo similar sucede con el PV. Si un administrador elimina un PV adjunto a un PVC, el PV no se elimina inmediatamente. La eliminación del PV se pospone hasta que el PV ya no esté vinculado a un PVC.

Reciclar

Eso significa algo en el medio, funciona de manera similar a la política de Eliminar que explicamos anteriormente, pero no elimina el volumen en sí, sino que eliminará el contenido del PV, por lo que en la práctica será similar. Entonces, al final, ejecutará un comando similar a este rm -rf en el artefacto de almacenamiento en sí. Pero solo para que estés al tanto, esta política está actualmente obsoleta, y no deberías usarla en tus nuevas cargas de trabajo, pero todavía es compatible, por lo que puedes encontrar algunas cargas de trabajo que aún la están usando.

📚 Want to dive deeper into Kubernetes? This article is part of our comprehensive Kubernetes Architecture Patterns guide, where you’ll find all fundamental and advanced concepts explained step by step.

Preguntas frecuentes

¿Cuál es la reclaim policy por defecto de un PersistentVolume?

Los PVs aprovisionados dinámicamente usan Delete por defecto: el volumen y sus datos se eliminan al borrar la PVC. Los PVs estáticos usan Retain. Esta asimetría explica casi todos los «borramos un namespace y perdimos los datos».

¿Qué diferencia hay entre Retain y Delete?

Delete elimina el recurso de almacenamiento subyacente (volumen EBS, disco) al desaparecer la PVC. Retain conserva el volumen y sus datos, pero el PV queda en estado Released y no es reutilizable hasta que un administrador limpia el claimRef. Retain protege los datos, pero acumula volúmenes huérfanos si nadie limpia.

¿Cómo cambio la reclaim policy de un PV existente?

Con un patch directo: kubectl patch pv <nombre> -p '{"spec":{"persistentVolumeReclaimPolicy":"Retain"}}'. Hacerlo antes de borrar una PVC es la forma estándar de conservar los datos mientras reorganizas claims.

¿Puedo reutilizar un PV en estado Released?

Sí, pero no automáticamente. Elimina la referencia al claim antiguo (kubectl patch pv <nombre> --type json -p '[{"op":"remove","path":"/spec/claimRef"}]') y el PV vuelve a Available — con los datos anteriores intactos, así que límpialo primero si el nuevo consumidor no debe verlos.

¿Por qué es tan genial el modo agente de Prometheus?

¿Por qué es tan genial el modo agente de Prometheus?

Prometheus ha incluido una nueva capacidad en la versión 2.32.0 para optimizar el enfoque de un solo panel de vidrio 

A partir de la nueva versión próxima de Prometheus v2.32.0, tendremos una nueva característica importante a nuestra disposición: el Modo Agente. Y hay una fantástica publicación en el blog anunciando esta característica de uno de los rockstars del equipo de Prometheus: Bartlomiej Plotka, que recomiendo leer. Agregaré una sección de referencia al final del artículo. Intentaré resumir algunos de los puntos más relevantes aquí. Otra publicación sobre Prometheus, el sistema de monitoreo más crítico en las arquitecturas nativas de la nube de hoy en día, tiene su origen en el sistema de monitoreo Borgmon creado por Google en tiempos antiguos (alrededor del período 2010–2014). Basado en esta importancia, su uso ha estado creciendo increíblemente y fortaleciendo su relación con el ecosistema de Kubernetes. Hemos llegado a un punto en que Prometheus es la opción predeterminada para el monitoreo en prácticamente cualquier escenario que tenga una carga de trabajo relacionada con Kubernetes; algunos ejemplos son los que se muestran a continuación:
  • Prometheus es la opción predeterminada, incluyendo el Sistema de Monitoreo de Openshift
  • Prometheus tiene un Servicio Gestionado de Amazon a su disposición para ser utilizado en sus cargas de trabajo.
  • Prometheus está incluido en la Arquitectura de Referencia para Despliegues Nativos de la Nube de Azure.
Debido a esta popularidad y crecimiento, muchos casos de uso diferentes han planteado algunas mejoras que se pueden realizar. Algunos de ellos están relacionados con casos de uso específicos como el despliegue en el borde o proporcionar una vista global, o un solo panel de vidrio. Hasta ahora, si tengo varios despliegues de Prometheus, monitoreo un subconjunto específico de sus cargas de trabajo debido a que residen en diferentes redes o porque hay varios clústeres, puede confiar en la capacidad de escritura remota para agregar eso en un enfoque de vista global. La Escritura Remota es una capacidad que ha existido en Prometheus desde su creación. Las métricas que Prometheus está recopilando se pueden enviar automáticamente a un sistema diferente utilizando sus integraciones. Esto se puede configurar para todas las métricas o solo un subconjunto. Pero incluso con todo esto, están avanzando en esta capacidad, por lo que están introduciendo el modo Agente. El Modo Agente optimiza el caso de uso de escritura remota configurando la instancia de Prometheus en un modo específico para realizar este trabajo de manera optimizada. Ese modelo implica la siguiente configuración:
  • Desactivar consultas y alertas.
  • Cambiar el almacenamiento local por un TSDB WAL personalizado
Y lo notable es que todo lo demás es igual, por lo que seguiremos utilizando la misma API, descubriendo capacidades y configuración relacionada. ¿Y qué te proporcionará todo esto? Veamos los beneficios que obtendrás al hacerlo:
  • Eficiencia: El TSDB WAL personalizado mantendrá solo los datos que no pudieron ser enviados al lugar de destino; tan pronto como tenga éxito, eliminará esa pieza de datos.
  • Escalabilidad: Mejorará la escalabilidad, permitiendo una escalabilidad horizontal más fácil para la ingesta. Esto se debe a que este modo agente desactiva algunas de las razones por las que la autoestabilidad es compleja en el modo servidor normal de Prometheus. Una carga de trabajo con estado hace que la escalabilidad sea compleja, especialmente en escenarios de reducción de escala. Así que este modo llevará a una carga de trabajo «más sin estado» que simplificará este escenario y estará cerca del sueño de un sistema de ingesta de métricas de autoescalabilidad.
Esta característica está disponible como una bandera experimental en la nueva versión, pero ya fue probada con los trabajos de Grafana Labs, especialmente en el lado del rendimiento. Si deseas ver más detalles sobre esta característica, te recomendaría echar un vistazo al siguiente artículo: https://prometheus.io/blog/2021/11/16/agent/

📚 Want to dive deeper into Kubernetes? This article is part of our comprehensive Kubernetes Architecture Patterns guide, where you’ll find all fundamental and advanced concepts explained step by step.

Aprende Cuánto Puedes Ganar en Medium Como Escritor Regular

Aprende Cuánto Puedes Ganar en Medium Como Escritor Regular

Echemos un vistazo a mis métricas de Medium en detalle para que puedas estimar las tuyas — Mi año 2021 en revisión.

Quiero hacer este artículo para intentar ser lo más transparente posible sobre cómo ha ido mi año en Medium en diferentes aspectos: lectores, seguidores, suscriptores… ¡y sí, ganancias!

Sé que hay muchos artículos que explican muchas ideas sobre cómo están funcionando en Medium. Y, probablemente, no verás aquí los números más significativos en ninguna de las métricas que podría elegir, por lo que creo que este es un buen post para todos.

Este post te muestra cómo algo tan regular como podrías ser si decides comenzar tu viaje como escritor en Medium puede funcionar con la misma dedicación que yo le pongo.

La motivación adicional para este post es establecer las expectativas para el próximo año que espero sea mejor. Podría enfocarme más en esta gran actividad de compartir conocimiento con toda la audiencia y la gran comunidad que estamos creando aquí en Medium.

Publicaciones Escritas

Esta sección cubre la primera métrica en la que me gustaría centrarme porque esta es la más importante. Y esto es claro. Si escribes más, te involucrarás más con tu audiencia. Por supuesto, el contenido necesita ser de excelente calidad, pero es esencial que el número de publicaciones que escribas sea alto y la frecuencia sea estable para que puedas crecer una comunidad y sepan cuándo pueden esperar la próxima pieza. Como sabes, este no es mi primer trabajo o dedicación, así que no soy tan bueno en este aspecto como debería ser, pero déjame mostrarte los números:

Aprende Cuánto Puedes Ganar en Medium Como Escritor Regular
Publicaciones publicadas por mes

Como puedes ver, trato de mantener la estabilidad en mis publicaciones, tratando de apuntar a un período semanal, así que tratando de alcanzar 4 por mes. Sin embargo, pude mantenerlo durante la mitad de los meses. Además, puedes ver el impulso en la motivación cuando comienzas un nuevo año, como puedes ver en los primeros tres meses del año. Así que, en total, puedes ver que he publicado 46 publicaciones. No es una marca significativa, pero es lo que pude hacer.

Seguidores y Suscriptores

Esta métrica es prácticamente la más importante porque te dice cómo se comporta tu comunidad. Si estás interactuando con ellos, si les gustan los temas que escribes, y cómo los cambios que estás haciendo están afectando a esta comunidad. Esta comunidad es tu núcleo, y decidirá cómo se comporta el resto. Necesitas invertir en ella, la alimentarás. Necesitas tratarla como se merece.

Entonces, ¿cuáles son mis números en este tema? No comencé desde cero, así que déjame compartir primero los números que tenía el 1 de enero de 2021: 119 Seguidores, 0 Suscriptores de correo electrónico, y 0 Miembros referidos (esto es normal ya que se introdujo en un punto tardío este año). Así que, aquí están los números para el año 2021:

Aprende Cuánto Puedes Ganar en Medium Como Escritor Regular
Métricas de Seguidores y Suscriptores en 2021

Así que, estoy terminando el año con un total de 261 suscriptores, lo que significa un aumento del 120%, lo cual es excelente. Aún así, este aumento ha sido fantástico hasta octubre, y después de eso, es un poco estable, y como puedes ver, coincide con la menor cantidad de publicaciones publicadas de mi parte. Así que puedes ver la tendencia genuinamente porque la comunidad está creciendo y tus publicaciones publicadas. Si no me crees, echemos un vistazo a este gráfico:

Aprende Cuánto Puedes Ganar en Medium Como Escritor Regular
Publicaciones publicadas por mes (línea roja) vs. Nuevos seguidores mensuales (barras azules)

Así que, como puedes ver, necesitas invertir para comenzar a ver crecer tu comunidad. Después de mis tres grandes meses con muchas publicaciones, pude ver eso. Después de ese punto, cuando mi tasa de publicación disminuyó, también lo hizo el crecimiento de la comunidad. Y, cuando mantuve el ritmo constante, pude mantener constante el crecimiento. Así que, cuanto más publiques, más consistente seas, más fuerte crecerá tu comunidad.

¡Muéstrame el dinero!

Y por último… pero no menos importante, porque estoy seguro de que esto es lo que te gustaría ver, las diferentes ganancias. Así que hablaré aquí sobre las ganancias antes de impuestos para que podamos comparar las mismas cosas y sería más beneficioso para ti, pero antes de comenzar una advertencia: Tuvimos «un año diferente» debido al programa de socios de Medium en el que pude participar algunos meses del año, lo que hace que mi año sea mucho más exitoso de lo que podría pensar, pero aquí están los números, pero antes de comenzar de nuevo, veamos el punto de partida. En diciembre de 2020, gané $30,41 con todas las publicaciones que había publicado.

Aprende Cuánto Puedes Ganar en Medium Como Escritor Regular
Ganancias por mes en 2021

Así que, como puedes ver, no me estoy haciendo rico, pero eso es justo. Obtengo mucha alegría de escribir y compartir mi conocimiento, y si alguna de mis publicaciones te ha ayudado, esto es más importante para mí que cualquier número que puedas ver en el gráfico anterior. Pero hablemos de los números:

  • Puedes ver varios períodos: el donde tuvimos el impulso del Programa de Socios de Medium es claro en la pantalla (agosto — octubre de 2021), y otros fueron buenos porque algunas publicaciones generaron mucha atención. El resto establece la barra base, y podemos considerar la «ganancia base».
  • Lo bueno de Medium es que esto se basa en tus espectadores mensuales y tiempo de lectura, por lo que todas las publicaciones que has publicado durante toda tu vida están contando y generando ingresos cada mes. Así que, de nuevo, cuanto más publiques, más generarás porque no es lo mismo generar $0.01 por publicación cuando tienes 100 publicaciones que cuando tienes 10,000 publicaciones.
  • He ganado (antes de impuestos) $965.06, lo que es un promedio de $87.73 / mes en los 11 meses que he considerado para este estudio. Así que no está mal al menos para ayudarte a pagar algunas herramientas que usas para escribir y animarte a continuar en 2022 con más fuerza.

Resumen

Espero que te haya gustado este post, y de nuevo, intenté ser lo más transparente posible, y espero que lo hayas reconocido. Esto es para mostrarte cómo alguien como yo que usa parte de su tiempo libre para escribir puede ganar en Medium. Seguro, esto no me hará rico, al menos no en ninguna moneda con la que pueda comerciar, pero hay muchas más cosas que solo $ y BTC cuando hablas de cosas que todo este trabajo está generando.

Así que, ¡espero poder contar contigo para nuestro viaje en 2022!

¿Cómo configurar un clúster local de Openshift?

¿Cómo configurar un clúster local de Openshift?

Aprende cómo puedes usar CodeReady Containers para configurar la última versión de Openshift Local solo en tu computadora.

Ejecutar Openshift Local
Foto de pawel szvmanski en Unsplash
En este momento, todos sabemos que el modo de implementación predeterminado para cualquier aplicación que queramos lanzar será una plataforma basada en contenedores y, especialmente, será una plataforma basada en Kubernetes. Pero ya sabemos que hay muchas variantes diferentes de distribuciones de Kubernetes, incluso escribí un artículo sobre eso que puedes encontrar aquí: Algunas de estas distribuciones intentan seguir lo más cerca posible la experiencia de Kubernetes, pero otras están tratando de mejorar y aumentar las capacidades que la plataforma proporciona. Debido a eso, a veces es importante tener una forma de realmente probar nuestro desarrollo en la plataforma objetivo sin esperar un modo de desarrollador basado en servidor. Sabemos que tenemos en nuestra propia laptop una plataforma basada en Kubernetes para ayudar a hacer el trabajo. minikube es la opción más común para hacer esto y proporcionará una vista muy básica de Kubernetes, pero a veces necesitamos un tipo diferente de plataforma. Openshift de RedHat se está convirtiendo en una de las soluciones de facto para implementaciones en la nube privada y especialmente para cualquier empresa que no planea mudarse a una solución gestionada en la nube pública como EKS, GKE o AKS. En el pasado teníamos un proyecto similar a minikube conocido como minishift que permitía ejecutar en sus propias palabras: Minishift es una herramienta que te ayuda a ejecutar OpenShift localmente ejecutando un clúster de OpenShift de un solo nodo dentro de una VM. Puedes probar OpenShift o desarrollarlo, día a día, en tu localhost. El único problema con minishift es que solo soportan la versión 3.x de Openshift, pero estamos viendo que la mayoría de los clientes ya están actualizando a la versión 4.x, por lo que podríamos pensar que estamos un poco solos en esa tarea, ¡pero esto está lejos de la verdad! Porque tenemos CodeReady Containers o CRC para ayudarnos en esa tarea. El propósito de Code Ready Containers es proporcionarte un clúster mínimo de Openshift optimizado para propósitos de desarrollo. Su proceso de instalación es muy, muy simple. Funciona de manera similar al modo de distribución anterior de VM y OVA, por lo que necesitarás obtener algunos binarios para poder configurar esto directamente desde Red Hat usando la siguiente dirección: https://console.redhat.com/openshift/create/local Necesitarás crear una cuenta, pero es gratuita y en unos pocos pasos obtendrás un gran binario de aproximadamente 3–4 GB y tu código de firma para poder ejecutar la plataforma y eso es todo, en unos minutos tendrás a tu disposición una plataforma completa de Openshift lista para que la uses.
¿Cómo configurar un clúster local de Openshift?
Instalación local de CodeReadyContainers en tu laptop
Podrás encender y apagar la plataforma usando los comandos crc start y crc stop.
¿Cómo configurar un clúster local de Openshift?
Salida de consola de la ejecución del comando crc start
Como puedes imaginar, esto solo es adecuado para el entorno local y de ninguna manera para la implementación en producción y también tiene algunas restricciones que pueden afectarte, tales como:
  • El clúster de OpenShift de CodeReady Containers es efímero y no está destinado para uso en producción.
  • No hay una ruta de actualización compatible a versiones más nuevas de OpenShift. Actualizar la versión de OpenShift puede causar problemas que son difíciles de reproducir.
  • Utiliza un solo nodo que actúa como nodo maestro y trabajador.
  • Desactiva el Operador de monitoring por defecto. Este Operador desactivado causa que la parte correspondiente de la consola web no funcione.
  • La instancia de OpenShift se ejecuta en una máquina virtual. Esto puede causar otras diferencias, particularmente con la red externa.
Espero que encuentres esto útil y que puedas usarlo como parte de tu proceso de implementación.

📚 Want to dive deeper into Kubernetes? This article is part of our comprehensive Kubernetes Architecture Patterns guide, where you’ll find all fundamental and advanced concepts explained step by step.

Temas Avanzados de Kubernetes: Contenedores de Inicialización

Temas Avanzados de Kubernetes: Contenedores de Inicialización

Descubre cómo los Init Containers pueden proporcionar capacidades adicionales a tus cargas de trabajo en Kubernetes

Hay muchos nuevos desafíos que vienen con el nuevo patrón de desarrollo de una manera mucho más distribuida y colaborativa, y cómo gestionamos las dependencias es crucial para nuestro éxito. Kubernetes y las distribuciones dedicadas se han convertido en el nuevo estándar de implementación para nuestra aplicación nativa de la nube y proporcionan muchas características para gestionar esas dependencias. Pero, por supuesto, el recurso más habitual que utilizarás para hacer eso son las sondas. Kubernetes proporciona diferentes tipos de sondas que permitirán a la plataforma conocer el estado de tu aplicación. Nos ayudará a saber si nuestra aplicación está «viva» (sonda de vivacidad), ha sido iniciada (sonda de inicio) y si está lista para procesar solicitudes (sonda de preparación).
Temas Avanzados de Kubernetes: Contenedores de Inicialización
Ciclo de vida de las sondas de Kubernetes por Andrew Lock (https://andrewlock.net/deploying-asp-net-core-applications-to-kubernetes-part-6-adding-health-checks-with-liveness-readiness-and-startup-probes/)
Las sondas de Kubernetes son la forma estándar de hacerlo, y si has implementado alguna carga de trabajo en un clúster de Kubernetes, probablemente hayas usado una. Pero hay ocasiones en las que esto no es suficiente. Eso puede ser porque la sonda que te gustaría hacer es demasiado compleja o porque te gustaría crear algún orden de inicio entre tus componentes. Y en esos casos, confías en otra herramienta: los Init Containers. Los Init Containers son otro tipo de contenedor en el que tienen su propia imagen que puede tener cualquier herramienta que puedas necesitar para establecer los diferentes chequeos o sondas que te gustaría realizar. Tienen las siguientes características únicas:
  • Los init containers siempre se ejecutan hasta completarse.
  • Cada init container debe completarse con éxito antes de que comience el siguiente.

¿Por qué usarías init containers?

#1 .- Gestionar Dependencias

El primer caso de uso para utilizar init containers es definir una relación de dependencias entre dos componentes como Deployments, y necesitas que uno comience antes que el otro. Imagina la siguiente situación: Tenemos dos componentes: una aplicación web y una base de datos; ambos se gestionan como contenedores en la plataforma. Así que si los implementas de la manera habitual, ambos intentarán comenzar simultáneamente, o el programador de Kubernetes definirá el orden, por lo que podría ser posible que la aplicación web intente comenzar cuando la base de datos no esté disponible. Podrías pensar que eso no es un problema porque para eso tienes una sonda de preparación o de vivacidad en tus contenedores, y tienes razón: el Pod no estará listo hasta que la base de datos esté lista, pero hay varias cosas a tener en cuenta aquí:
  • Ambas sondas tienen un límite de intentos; después de eso, entrarás en un escenario de CrashLoopBack, y el pod no intentará comenzar de nuevo hasta que lo reinicies manualmente.
  • El pod de la aplicación web consumirá más recursos de los necesarios cuando sabes que la aplicación no comenzará en absoluto. Así que, al final, estás desperdiciando recursos en el proceso.
Por lo tanto, definir un init container como parte de la implementación de la aplicación web que verifique si la base de datos está disponible, tal vez solo incluyendo un cliente de base de datos para ver rápidamente si la base de datos y todas las tablas están adecuadamente pobladas, será suficiente para resolver ambas situaciones.

#2 .- Optimización de recursos

Una cosa crítica cuando defines tus contenedores es asegurarte de que tienen todo lo que necesitan para realizar su tarea y que no tienen nada que no sea necesario para ese propósito. Así que en lugar de agregar más herramientas para verificar el comportamiento del componente, especialmente si esto es algo para gestionar en momentos específicos, puedes descargar eso a un init container y mantener el contenedor principal más optimizado en términos de tamaño y recursos utilizados.

#3.- Precarga de datos

A veces necesitas realizar algunas actividades al inicio de tu aplicación, y puedes separar eso del trabajo habitual de tu aplicación, por lo que te gustaría evitar el tipo de lógica para verificar si el componente ha sido inicializado o no. Usando este patrón, tendrás un init container gestionando todo el trabajo de inicialización y asegurando que todo el trabajo de inicialización se haya realizado cuando se ejecute el contenedor principal.
Temas Avanzados de Kubernetes: Contenedores de Inicialización
Ejemplo del proceso de inicialización (https://www.magalix.com/blog/kubernetes-patterns-the-init-container-pattern)

¿Cómo definir un Init Container?

Para poder definir un init container, necesitas usar una sección específica de la sección de especificaciones de tu archivo YAML, como se muestra en la imagen a continuación:
apiVersion: v1
kind: Pod
metadata:
name: myapp-pod
labels:
app: myapp
spec:
containers:
  - name: myapp-container
image: busybox:1.28
command: ['sh', '-c', 'echo ¡La aplicación está en ejecución! && sleep 3600']
initContainers:
  - name: init-myservice
image: busybox:1.28
command: ['sh', '-c', "until nslookup myservice.$(cat /var/run/secrets/kubernetes.io/serviceaccount/namespace).svc.cluster.local; do echo esperando a myservice; sleep 2; done"]
  - name: init-mydb
image: busybox:1.28
command: ['sh', '-c', "until nslookup mydb.$(cat /var/run/secrets/kubernetes.io/serviceaccount/namespace).svc.cluster.local; do echo esperando a mydb; sleep 2; done"]
Puedes definir tantos Init Containers como necesites. Sin embargo, notarás que todos los init containers se ejecutarán en secuencia como se describe en el archivo YAML, y un init container solo puede ejecutarse si el anterior se ha completado con éxito.

Resumen

Espero que este artículo te haya proporcionado una nueva forma de definir la gestión de tus dependencias entre cargas de trabajo en Kubernetes y, al mismo tiempo, también otros grandes casos de uso donde la capacidad del init container puede aportar valor a tus cargas de trabajo.

📚 Want to dive deeper into Kubernetes? This article is part of our comprehensive Kubernetes Architecture Patterns guide, where you’ll find all fundamental and advanced concepts explained step by step.

AccessModes facilita el camino para ejecutar cargas de trabajo con estado en la plataforma Kubernetes

AccessModes facilita el camino para ejecutar cargas de trabajo con estado en la plataforma Kubernetes

Los AccessModes de Kubernetes proporcionan mucha flexibilidad sobre cómo los diferentes pods pueden acceder a los volúmenes compartidos

Todas las empresas se están moviendo hacia una transformación, cambiando las cargas de trabajo actuales en servidores de aplicaciones que se ejecutan en máquinas virtuales en un centro de datos hacia una arquitectura nativa de la nube donde las aplicaciones se han descompuesto en diferentes servicios que se ejecutan como componentes aislados utilizando contenedores y gestionados por una plataforma basada en Kubernetes. Comenzamos con los casos de uso y cargas de trabajo más fáciles, moviendo nuestros servicios en línea, principalmente API REST que funcionan en modo de balanceo de carga, pero los problemas comenzaron cuando movimos otras cargas de trabajo para seguir el mismo camino de transformación. La plataforma Kubernetes no estaba lista en ese momento. La mayoría de sus mejoras se han realizado para admitir más casos de uso. ¿Significa eso que la API REST es mucho más nativa de la nube que una aplicación que requiere una solución de almacenamiento de archivos? ¡Absolutamente no! Estábamos confundiendo diferentes cosas. Los patrones nativos de la nube son válidos independientemente de esas decisiones. Sin embargo, es cierto que en el camino hacia la nube e incluso antes, hubo algunos patrones que intentamos reemplazar, especialmente los basados en archivos. Pero esto no es por el uso del archivo en sí. Era más sobre el enfoque por lotes que estaba estrechamente relacionado con el uso de archivos que intentamos reemplazar por varias razones, como las siguientes:
  • El enfoque en línea reduce el tiempo de acción: las actualizaciones y notificaciones llegan más rápido al objetivo, por lo que los componentes están actualizados.
  • Las soluciones basadas en archivos reducen la escalabilidad de la solución: generas una dependencia con un componente central que tiene una solución de escalabilidad más compleja.
Pero este camino se está facilitando, y la última actualización en ese viaje fueron los Access Modes introducidos por Kubernetes. El Access Mode define cómo los diferentes pods interactuarán con un volumen persistente específico. Los modos de acceso son los que se muestran a continuación.
  • ReadWriteOnce — el volumen puede montarse como lectura-escritura por un solo nodo
AccessModes facilita el camino para ejecutar cargas de trabajo con estado en la plataforma Kubernetes
Representación Gráfica de ReadWriteOnce AccessMode
  • ReadOnlyMany — el volumen puede montarse como solo lectura por muchos nodos.
AccessModes facilita el camino para ejecutar cargas de trabajo con estado en la plataforma Kubernetes
Representación Gráfica de ReadOnlyMany AccessMode
  • ReadWriteMany — el volumen puede montarse como lectura-escritura por muchos nodos
AccessModes facilita el camino para ejecutar cargas de trabajo con estado en la plataforma Kubernetes
Representación Gráfica de ReadWriteMany AccessMode
  • ReadWriteOncePod — el volumen puede montarse como lectura-escritura por un solo Pod. Esto solo es compatible con volúmenes CSI y Kubernetes versión 1.22+.
AccessModes facilita el camino para ejecutar cargas de trabajo con estado en la plataforma Kubernetes
Representación Gráfica de ReadWriteOncePod AccessMode
Puedes definir el modo de acceso como una de las propiedades de tus PVs y PVCs, como se muestra en el ejemplo a continuación:
kind: PersistentVolumeClaim
apiVersion: v1
metadata:
 name: single-writer-only
spec:
 accessModes:
 - ReadWriteOncePod # Permitir solo a un único pod acceder a single-writer-only.
 resources:
 requests:
 storage: 1Gi
Todo esto nos ayudará en nuestro camino para que todos nuestros diferentes tipos de cargas de trabajo logren todos los beneficios de la transformación digital y nos permita, como arquitectos o desarrolladores, elegir el patrón correcto para nuestro caso de uso sin estar restringidos en absoluto.

📚 Want to dive deeper into Kubernetes? This article is part of our comprehensive Kubernetes Architecture Patterns guide, where you’ll find all fundamental and advanced concepts explained step by step.

Enfrentémoslo: ¡Los mejores desarrolladores no están en Twitch o YouTube!

Enfrentémoslo: ¡Los mejores desarrolladores no están en Twitch o YouTube!

Los creadores de contenido están educando a los desarrolladores junior en plataformas sociales que probablemente idealizan su visión incluso cuando no son los mejores de su clase.

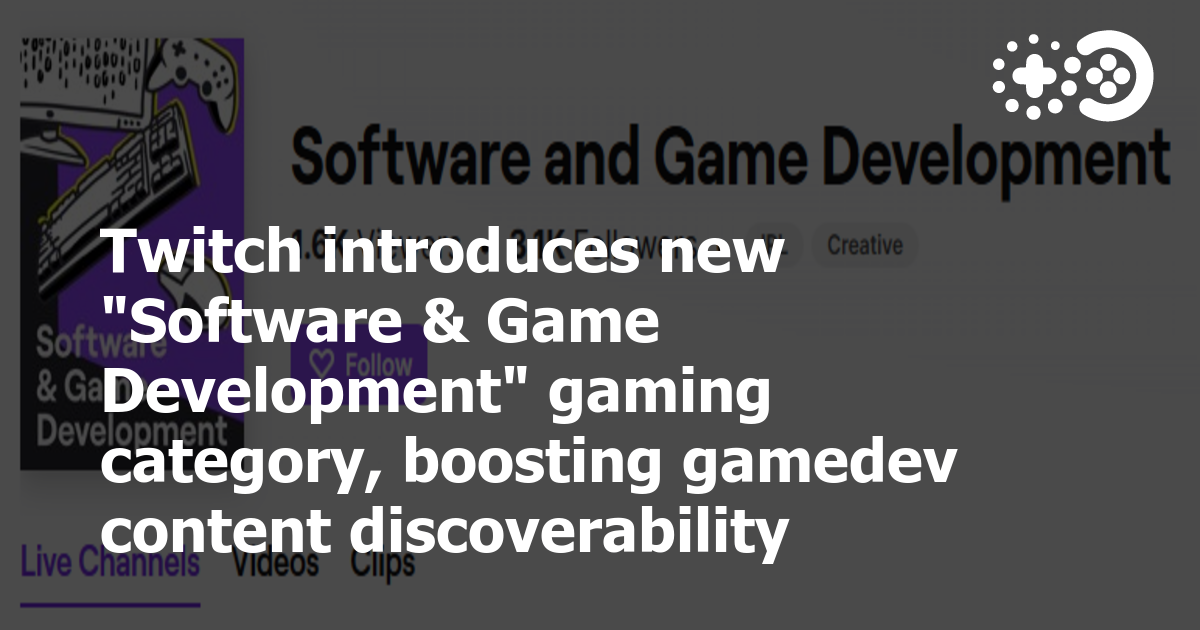
Estamos viviendo un momento de máxima exposición a la creación de contenido con temas de desarrollo de software. La última noticia sobre este tema es la creación de una sección específica sobre Canales de Desarrollo de Software en la popular plataforma de streaming Twitch:

Y eso es solo una etapa adicional en la tendencia que estamos viendo en los últimos años donde el contenido creado y las personas que invierten su tiempo en compartir su conocimiento en internet están explotando.

Enfrentémoslo: ¡Los mejores desarrolladores no están en Twitch o YouTube!
El pie de foto del Desarrollo de Software y Juegos de Twitch.tv

Prácticamente puedes encontrar un Canal en Vivo que te enseñará o compartirá contigo mucho conocimiento y experiencia sobre todos los temas relacionados con el desarrollo de software. No importa qué tema estés buscando, lo tendrás allí. Por ejemplo, hoy más temprano fui. Encontré los siguientes canales en vivo: Creando un MMO desde cero, Desarrollo de Maya, Programación en Java, Programación en GoLang, Programación de CMS usando Django y Python, y mucho más.

Esto es algo grandioso. Vivimos en una era donde tenemos contenido de gran calidad a nuestra disposición, especialmente en nuestra industria, que nos ayudará a mejorar nuestras habilidades y base de conocimientos. Todos estos creadores de contenido son los principales contribuyentes a eso. Y esos están aumentando la popularidad de los mejores creadores de contenido alcanzando niveles sobresalientes.

Pero esa situación también está creando la circunstancia de que los desarrolladores junior o simplemente personas que comienzan una nueva habilidad comiencen a pensar que las personas que muestran su visión o experiencia sobre un tema son los mejores desarrolladores en esa área, y eso está muy lejos de la verdad. Así que se está inclinando hacia una situación peligrosa.

Para ser claro: Los Creadores de Contenido no suelen ser Grandes Desarrolladores. Normalmente son desarrolladores regulares con habilidades de comunicación impresionantes. Y eso es más importante con una voluntad de compartir lo que saben con su audiencia. Incluso que están ganando dinero con esto, para ser justos, tienen una determinación inequívoca de desempeñar un papel social de compartir el conocimiento con el mundo, y eso es muy importante.

Esto no es solo intentar avergonzar a los creadores de contenido por su calidad; esto está sucediendo en todas las industrias. El mejor conocimiento compartido no suele ser el mejor de su práctica. Puedes pensar en cualquier tema: Matemáticas, Física, pero también Deportes. ¿Son los mejores narradores de Fútbol los mejores jugadores? No, seguro.

Pero por esta razón, es importante tener en cuenta esto cuando asistimos a esos canales o vemos esos videos que no son los verdaderos expertos, por lo que siempre debes verificar sus declaraciones para asegurarte de que estén alineadas con las mejores prácticas y procesos.

Si te gustaría ver lo que los verdaderos buenos desarrolladores están haciendo, es mucho más fácil encontrarlo cerca de donde reside el código. Usando plataformas como GitHub o SourceForge, los proyectos con más estrellas que proporcionan valor y leyendo sus conversaciones o analizando sus commits, te proporcionaremos una visión mucho más clara de lo que los verdaderos desarrolladores de alto nivel están haciendo.

Enfrentémoslo: ¡Los mejores desarrolladores no están en Twitch o YouTube!
Proyectos de GitHub que proporcionan una fuente increíble de conocimiento y buenas prácticas

Otra opción es suscribirse a la lista de correo de esos proyectos donde puedes ver la discusión real de los desarrolladores, los puntos principales que están haciendo y el razonamiento detrás de esas decisiones.

Enfrentémoslo: ¡Los mejores desarrolladores no están en Twitch o YouTube!
Una lista de correo te ayudará a entender cuál es el razonamiento detrás de algunas decisiones importantes de software

Este es un conocimiento mucho más importante que lo que puedes ver en una sesión en vivo de alguien programando en una plataforma de streaming, pero esto también es parte del proceso porque necesitarás tener la base para estar listo para entender a qué se refiere la discusión y para ese nivel de introducción la forma en que este increíble creador de contenido está compartiendo el conocimiento es la mejor manera para que cualquiera lo entienda y lo asimile.

¿Es gRPC tan rápido en comparación con REST como dice toda la industria?

¿Es gRPC tan rápido en comparación con REST como dice toda la industria?

Vamos a ver si el protocolo gRPC, que está surgiendo como una de las fuertes alternativas frente al servicio REST tradicional, puede mostrar todos los beneficios que la gente está reclamando

Si ya has estado en la industria tecnológica últimamente, sabes que gRPC se está convirtiendo en uno de los protocolos más populares para la integración entre componentes, principalmente microservicios, debido a sus beneficios en comparación con otras soluciones estándar como REST o SOAP.

Hay otras alternativas que también se están volviendo mucho más populares a diario, como GraphQL, pero el enfoque de hoy es en gRPC. Si deseas echar un vistazo a los beneficios de GraphQL, puedes ver el artículo que se muestra a continuación:

Entonces, ¿cuáles son los principales beneficios que generalmente se exponen respecto al uso de gRPC y por qué empresas como Netflix o Uber lo están utilizando?

  • Mensajes ligeros
  • Alto rendimiento
  • Soporte para patrón de transmisión

Parece una buena alternativa de una versión renovada de la llamada a procedimiento remoto tradicional que se ha estado utilizando en los años 90, pero probémoslo en algunos casos de uso real para intentar medir los beneficios que todos están reclamando, especialmente en cuanto al rendimiento y la ligereza de los mensajes, así que decidí definir un escenario muy sencillo de un patrón de solicitud/respuesta entre dos aplicaciones y probarlas con una llamada REST normal y una llamada gRPC.

¿Es gRPC tan rápido en comparación con REST como dice toda la industria?
Definición de Escenario de Prueba Simple

Pila Tecnológica

Vamos a usar TIBCO Flogo para crear la aplicación y utilizar un entorno visual sin código para simplificar la generación de la aplicación. Si deseas ver más en detalle sobre esta tecnología, por favor revisa el post a continuación:

Entonces, vamos a crear dos aplicaciones: La primera se activará en intervalos programados cada 100 ms y llamará usando gRPC a la segunda aplicación que simplemente devolverá los datos a la aplicación de llamada codificados de manera fija para evitar que cualquier otro sistema de terceros pueda impactar en la medición del rendimiento.

En cuanto a los datos que vamos a transmitir, será un enfoque simple de Hola Mundo. La primera aplicación enviará un nombre a la segunda aplicación que devolverá el “Hola, nombre, Esta es mi aplicación gRPC (o REST)” para poder imprimirlo en la consola.

Enfoque REST

A continuación se muestran las aplicaciones para el caso de prueba utilizando la tecnología TIBCO Flogo para definirlo:

¿Es gRPC tan rápido en comparación con REST como dice toda la industria?
Aplicaciones Flogo para el caso REST 

Como puedes ver, es simple e intuitivo. Tenemos la primera aplicación activada por un Trigger y con una actividad de Invocación REST y luego un Mensaje de Registro para imprimir lo que se ha recibido. La segunda aplicación es aún más simple, solo expone la API REST y devuelve los datos codificados de manera fija.

Enfoque gRPC

El enfoque gRPC será un poco más difícil porque necesitamos crear la definición protobuf para el cliente y servidor gRPC. Así que comenzaremos con una definición simple del servicio Hello como puedes ver en la imagen a continuación:

¿Es gRPC tan rápido en comparación con REST como dice toda la industria?
Definición de Protobuf para el Escenario de Prueba gRPC

Y basado en eso, podemos generar las diferentes aplicaciones tanto del cliente como del servidor de esta prueba simple:

¿Es gRPC tan rápido en comparación con REST como dice toda la industria?
Aplicaciones gRPC en TIBCO Flogo

Como puedes ver, las aplicaciones son muy similares a las de REST, solo cambiando un protocolo por el otro, y eso es una de las cosas increíbles de TIBCO Flogo, podemos tener una implementación simple sin conocer los detalles de los protocolos más nuevos pero obteniendo todas las ventajas que proporcionan.

Resultados de la Prueba

Después de 100 ejecuciones del servicio REST, estas son las métricas que pudimos obtener usando el exportador de Prometheus que proporciona la herramienta:

¿Es gRPC tan rápido en comparación con REST como dice toda la industria?
Métricas de Prometheus para la Ejecución del Escenario REST

Así que tenemos alrededor de 4 ms para el flujo del cliente y 0.16 ms para el servicio REST en sí, por lo que ya son números bajos. ¿Realmente crees que una versión gRPC podría mejorarlo? Vamos a verlo. Aquí están las mismas métricas para 100 invocaciones del segundo flujo usando gRPC:

¿Es gRPC tan rápido en comparación con REST como dice toda la industria?
Métricas de Prometheus para la Ejecución del Escenario gRPC

Como puedes ver, la mejora es impresionante incluso para un servicio simple que se ejecuta en localhost. El servicio gRPC tuvo métricas de 0.035 ms frente a los 0.159 que tenía la versión REST, una mejora del 77.98% frente a la API REST, esto es simplemente increíble… pero ¿qué pasa con el cliente? Pasó de 4.066 ms a 0.89 ms, lo que significa otra mejora del 78.1%.

¿Es gRPC tan rápido en comparación con REST como dice toda la industria?
Representación Gráfica de Ambas Ejecuciones de Escenario

Entonces, la lógica debería ser si esto se puede hacer con un servicio simple donde los datos intercambiados son prácticamente nada, ¿qué puede hacer cuando la carga útil es grande? las opciones son simplemente inimaginables…

Resumen

Probamos las cosas buenas que hemos escuchado en línea sobre el método gRPC que la mayoría de las tecnologías de vanguardia están utilizando hoy en día y hemos quedado impresionados solo con un escenario simple comparándolo con el rendimiento de una interfaz REST. Seguro que gRPC tiene sus contras como cualquier otra opción, pero en términos de rendimiento y optimización de mensajes, los datos hablan por sí mismos, es simplemente asombroso. ¡Mantente atento a nuevas pruebas sobre los beneficios de gRPC y también algunos de sus contras para intentar ver si podría ser una gran opción para tu próximo desarrollo!