Proporcione más agilidad a sus esfuerzos de resolución de problemas depurando exactamente donde ocurre el error utilizando técnicas de Depuración Remota
La revolución de los contenedores ha proporcionado muchos beneficios, como hemos discutido en profundidad en otros artículos, y al mismo tiempo, también ha proporcionado algunos nuevos desafíos que necesitamos abordar.
Toda la agilidad que ahora tenemos en manos de nuestros desarrolladores también necesita extenderse al trabajo de mantenimiento y solución de problemas. Necesitamos ser ágiles también. Conocemos algunos de los principales problemas que tenemos al respecto: Funciona en mi entorno, con el conjunto de datos que tengo, no pude ver el problema, o no pude reproducir el error, son solo frases que escuchamos una y otra vez y retrasan la resolución de algunos errores o mejoras, incluso cuando la solución es simple, luchamos por obtener un escenario real para probar.
Y aquí es donde entra la Depuración Remota. La Depuración Remota es, tal como su propio nombre indica claramente, poder depurar algo que no es local, que es remoto. Se ha centrado desde su concepción en el Desarrollo Móvil porque no importa cuán bueno sea el simulador. Siempre necesitarás probar en un dispositivo real para asegurarte de que todo funcione correctamente.
Así que este es el mismo concepto pero aplicable a un contenedor, lo que significa que tengo una aplicación TIBCO BusinessWorks ejecutándose en Kubernetes. Queremos depurarla como si estuviera ejecutándose localmente, como se muestra en la imagen anterior. Para poder hacer eso, necesitamos seguir estos pasos:
Habilitar la Depuración Remota en el pod
El primer paso es habilitar la opción de depuración remota en la aplicación y para hacerlo, necesitamos usar la API interna que proporciona BusinessWorks, y para hacerlo, necesitamos ejecutar desde dentro del contenedor:
En caso de que no tengamos ninguna herramienta como curl o wget para acceder a una URL dentro del contenedor, siempre puedes usar la estrategia de port-forward para hacer que el puerto 8090 del pod sea accesible para habilitar el puerto de depuración usando un comando similar al siguiente:
Y luego, podemos acceder desde nuestra máquina local para habilitar la depuración remota
Hacer que el Puerto de Depuración sea accesible para el Studio
Para hacer la depuración remota, necesitamos poder conectar nuestro TIBCO BusinessStudio local a este pod específico que está ejecutando la carga y, para hacerlo, necesitamos tener acceso al puerto de depuración. Para obtener esto, tenemos principalmente dos opciones que son las que se muestran en las subsecciones a continuación: Exponer el puerto a nivel del pod y opción de port-forwarding.
Exponer el puerto a nivel del Pod
Necesitamos tener el puerto de depuración abierto en nuestro pod. Para hacer eso, necesitamos definir otro puerto que no esté en uso por la aplicación, y que no sea el puerto de administración predeterminado (8090) para el que se va a exponer. Por ejemplo, en mi caso, usaré 5554 como el puerto de depuración, y para hacerlo, defino otro puerto para ser accedido.
Definición del puerto de depuración como un Servicio
Opción de Port-Forwarding
Otra opción si no queremos exponer el puerto de depuración todo el tiempo, incluso si no se va a usar a menos que estemos ejecutando la depuración remota, tenemos otra opción para hacer un port-forward al puerto de depuración en nuestro local.
Ahora que tenemos todo listo, necesitamos conectar nuestro TIBCO Business Studio local al pod, y para hacerlo, necesitamos seguir estos pasos:
Ejecutar → Configuraciones de Depuración, y seleccionamos el BusinessWorks Remoto
Selección de la opción de aplicación BusinessWorks Remoto en la Configuración de Depuración
Y ahora necesitamos proporcionar los detalles de la conexión. Para este caso, usaremos el localhost y el puerto 5554 y haremos clic en el botón de Depuración.
Configuración de las propiedades de conexión para la Depuración Remota
Después de ese momento, estableceremos una conexión entre ambos entornos: el pod ejecutándose en nuestro clúster de Kubernetes y nuestro TIBCO BusinessStudio local. Y tan pronto como accedamos al contenedor, podemos ver la ejecución en nuestro entorno local:
Ejecución de Depuración Remota desde nuestra instancia de TIBCO BusinesStudio
Resumen
Espero que encuentres esto interesante, y si eres uno de los que enfrenta este problema ahora, tienes información para no detenerte por este. Si deseas enviar tus preguntas, no dudes en usar una de las siguientes opciones:
Twitter: Puedes enviarme una mención a @alexandrev en Twitter o un DM o incluso solo usando el hashtag #TIBFAQS que monitorearé.
Email: Puedes enviarme un correo electrónico a alexandre.vazquez en gmail.com con tu pregunta.
Instagram: Puedes enviarme un DM en Instagram a @alexandrev
Ahorra tiempo y dinero en tu plataforma de aplicaciones implementando aplicaciones de manera diferente en Kubernetes.
Venimos de una época en la que implementamos una aplicación utilizando un proceso aparente y lineal. La forma tradicional es más o menos así:
Esperar hasta un fin de semana o algún momento en que la carga sea baja y el negocio pueda tolerar cierta indisponibilidad del servicio.
Programamos el cambio y avisamos a todos los equipos involucrados para que estén listos para gestionar el impacto.
Implementamos la nueva versión y tenemos a todos los equipos durante la prueba funcional que necesitan hacer para asegurarse de que funciona bien, y esperamos a que ocurra la carga real.
Monitoreamos durante las primeras horas para ver si ocurre algo malo, y en caso de que sí, establecemos un proceso de reversión.
Tan pronto como todo va bien, esperamos hasta el próximo lanzamiento en 3-4 meses.
Pero esto ya no es válido. El negocio exige que TI sea ágil, cambie rápidamente y no pueda permitirse hacer ese tipo de esfuerzo de recursos cada semana o, peor aún, cada día. ¿Crees que es posible reunir a todos los equipos cada noche para implementar los últimos cambios? No es factible en absoluto. Entonces, la tecnología avanza para ayudarnos a resolver mejor ese problema, y aquí es donde Canarying vino a ayudarnos.
Introducción a los Despliegues Canary
Los despliegues canary (o simplemente Canarying, como prefieras) no son algo nuevo, y mucha gente ha estado hablando mucho sobre ello:
bliki: CanaryRelease
A canary release occurs when you roll out a new version of some software to a small subset of your user base to see if there are any problems before you make it available to everyone.
Google - Site Reliability Engineering
Release engineering is a term we use to describe all the processes and artifacts related to getting code from a repository into a running production system. Automating releases can help avoid many of the traditional pitfalls associated with release engineering: the toil of repetitive and manual task…
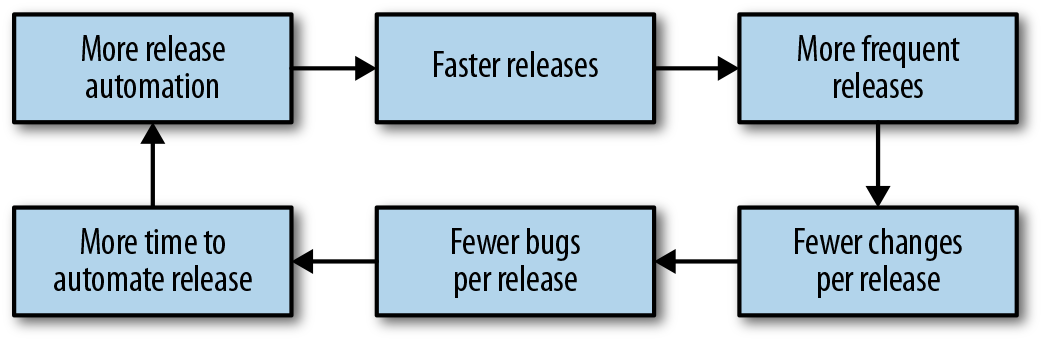
Ha estado aquí por algún tiempo, pero antes no era ni fácil ni práctico implementarlo. Básicamente se basa en implementar la nueva versión en producción, pero aún manteniendo el tráfico apuntando a la versión antigua de la aplicación y solo comienzas a desviar parte del tráfico a la nueva versión.Representación gráfica de un lanzamiento canary en un entorno de Kubernetes Basado en ese pequeño subconjunto de solicitudes, monitoreas cómo se desempeña la nueva versión en diferentes niveles, nivel funcional, nivel de rendimiento, etc. Una vez que te sientes cómodo con el rendimiento que está proporcionando, simplemente desvías todo el tráfico a la nueva versión y deprecias la versión antigua.Eliminación de la versión antigua después de que todo el tráfico ha sido desviado a la nueva versión implementada. Los beneficios que vienen con este enfoque son enormes:
No necesitas un gran entorno de pruebas como antes porque puedes hacer algunas de las pruebas con datos reales en producción sin afectar tu negocio y la disponibilidad de tus servicios.
Puedes reducir el tiempo de comercialización y aumentar la frecuencia de los despliegues porque puedes hacerlo con menos esfuerzo y personas involucradas.
Tu ventana de despliegue se ha extendido mucho ya que no necesitas esperar una ventana de tiempo específica, y debido a eso, puedes implementar nuevas funcionalidades con más frecuencia.
Implementando Despliegue Canary en Kubernetes
Para implementar Despliegue Canary en Kubernetes, necesitamos proporcionar más flexibilidad en cómo se enruta el tráfico entre nuestros componentes internos, que es una de las capacidades que se extienden al usar un Service Mesh. Ya discutimos los beneficios de usar un Service Mesh como parte de tu entorno, pero si deseas volver a echar un vistazo, por favor consulta este artículo:
Technology wars: API Management Solution vs Service Mesh
Service Mesh vs. API Management Solution: is it the same? Are they compatible? Are they rivals? Photo by Alvaro Reyes on Unsplash When we talk about communication in a distributed cloud-native world and especially when we are talking about container-based architectures based on Kubernetes platform like AKS, EKS, Openshift, and so on, two technologies generate a lot […]
Tenemos varios componentes tecnológicos que pueden proporcionar esas capacidades, pero así es como podrás crear las rutas de tráfico para implementar esto. Para ver cómo puedes echar un vistazo al siguiente artículo sobre una de las opciones predeterminadas que es Istio:
Integrating Istio with BWCE Applications
Introduction Services Mesh is one the “greatest new thing” in our PaaS environments. No matter if you’re working with K8S, Docker Swarm, pure-cloud with EKS or AWS, you’ve heard and probably tried to know how can be used this new thing that has so many advantages because it provides a lot of options in handling […]
Pero poder enrutar el tráfico no es suficiente para implementar un enfoque completo de despliegue canary. También necesitamos poder monitorear y actuar en base a esas métricas para evitar la intervención manual. Para hacer esto, necesitamos incluir diferentes herramientas para proporcionar esas capacidades: Prometheus es la opción de facto para monitorear cargas de trabajo implementadas en el entorno de Kubernetes, y aquí puedes obtener más información sobre cómo ambos proyectos trabajan juntos.
Kubernetes Service Discovery for Prometheus
In previous posts, we described how to set up Prometheus to work with your TIBCO BusinessWorks Container Edition apps, and you can read more about it here. In that post, we described that there were several ways to update Prometheus about the services that ready to monitor. And we choose the most simple at that […]
Y para gestionar el proceso general, puedes tener una herramienta de Despliegue Continuo para poner algo de gobernanza alrededor de eso usando opciones como Spinnaker o usando alguna de las extensiones para las herramientas de Integración Continua como GitLab o GitHub:
Using Spinnaker for Automated Canary Analysis
Automated canary analysis lets you partially roll out a change then evaluate it against the current deployment to assess its performance.
Resumen
En este artículo, cubrimos cómo podemos evolucionar un modelo de despliegue tradicional para mantener el ritmo de la innovación que los negocios requieren hoy y cómo las técnicas de despliegue canary pueden ayudarnos en ese viaje, y los componentes tecnológicos necesarios para configurar esta estrategia en tu propio entorno.
Maximizando la productividad al trabajar con el entorno de Kubernetes con una herramienta para cada persona
Todos sabemos que Kubernetes es el entorno predeterminado para todas nuestras nuevas aplicaciones que desarrollamos y construiremos. El sabor de esa plataforma de Kubernetes puede ser de diferentes maneras y formas, pero una cosa está clara, es complejo. Las razones detrás de esta complejidad son poder proporcionar toda la flexibilidad, pero también es cierto que el proyecto k8s nunca ha puesto mucho esfuerzo en proporcionar una forma sencilla de gestionar tus clústeres y kubectl es el punto de acceso para enviar comandos, dejando esta puerta abierta a la comunidad para proporcionar su propia solución y estas son las cosas que vamos a discutir hoy.
Tablero de Kubernetes: La Opción Predeterminada
El Tablero de Kubernetes es la opción predeterminada para la mayoría de las instalaciones. Es una interfaz basada en la web que es parte del proyecto K8s pero no se despliega por defecto cuando instalas el clúster.
K9S: La opción de CLI
K9S es una de las opciones más comunes para aquellos que aman una interfaz de línea de comandos muy poderosa con muchas opciones a su disposición. Es una mezcla entre todo el poder de una interfaz de línea de comandos con todas las opciones de teclado a tu disposición con una vista gráfica muy elegante para tener una visión rápida del estado de tu clúster de un vistazo.
Lens — La Opción Gráfica
Lens es una opción de GUI muy vitaminada que va más allá de solo mostrar el estado del clúster de K8S o permitir modificaciones en los componentes. Con integración con otros proyectos como Helm o soporte para el CRD. Proporciona una experiencia muy agradable de gestión de clústeres con soporte para múltiples clústeres también. Para saber más sobre Lens puedes echar un vistazo a este artículo donde cubrimos sus principales características:
Lens Could Be the Tool That You Were Missing to Master Kubernetes-Based Development and Management
Find the greatest way to manage your Kubernetes development cluster Photo by Agence Olloweb on Unsplash. I need to start this article by admitting that I am an advocate of Graphical User Interfaces and everything that provides a way to speed up the way we do things and be more productive. So when we talk […]
Octant — La Opción Web
Octant proporciona una experiencia mejorada en comparación con la opción web predeterminada discutida en este artículo usando el tablero de Kubernetes. Construido para la extensión con un sistema de complementos que te permite extender o personalizar el comportamiento de octant para maximizar tu productividad gestionando clústeres de K8S. Incluyendo soporte para CRD y visualización gráfica de dependencias, proporciona una experiencia increíble.
Resumen
Hemos proporcionado en este artículo diferentes herramientas que te ayudarán durante la importante tarea de gestionar o inspeccionar tu clúster de Kubernetes. Cada una de ellas con sus propias características y cada una de ellas se enfoca en diferentes formas de proporcionar la información (CLI, GUI y Web) para que siempre puedas encontrar una que funcione mejor para tu situación y preferencias.
KEDA proporciona un entorno rico para escalar su aplicación aparte del enfoque tradicional de HPA usando CPU y Memoria
El escalado automático es una de las grandes ventajas de los entornos nativos de la nube y nos ayuda a proporcionar un uso optimizado de las operaciones. Kubernetes ofrece muchas opciones para hacerlo, siendo una de ellas el enfoque del Escalador Automático de Pods Horizontal (HPA). HPA es la forma en que Kubernetes detecta si es necesario escalar alguno de los pods, y se basa en métricas como el uso de CPU o memoria. https://kubernetes.io/docs/tasks/run-application/horizontal-pod-autoscale/ A veces esas métricas no son suficientes para decidir si el número de réplicas que tenemos disponibles es suficiente. Otras métricas pueden proporcionar una mejor perspectiva, como el número de solicitudes o el número de eventos pendientes.
Escalado Automático Basado en Eventos de Kubernetes (KEDA)
Aquí es donde KEDA viene a ayudar. KEDA significa Escalado Automático Basado en Eventos de Kubernetes y proporciona un enfoque más flexible para escalar nuestros pods dentro de un clúster de Kubernetes. Se basa en escaladores que pueden implementar diferentes fuentes para medir el número de solicitudes o eventos que recibimos de diferentes sistemas de mensajería como Apache Kafka, AWS Kinesis, Azure EventHub y otros sistemas como InfluxDB o Prometheus. KEDA funciona como se muestra en la imagen a continuación: Tenemos nuestro ScaledObject que vincula nuestra fuente de eventos externa (es decir, Apache Kafka, Prometheus ..) con el Despliegue de Kubernetes que nos gustaría escalar y registrar eso en el clúster de Kubernetes. KEDA monitoreará la fuente externa y, basado en las métricas recopiladas, comunicará al Escalador Automático de Pods Horizontal para escalar la carga de trabajo según lo definido.
Probando el Enfoque con un Caso de Uso
Entonces, ahora que sabemos cómo funciona, haremos algunas pruebas para verlo en vivo. Vamos a mostrar cómo podemos escalar rápidamente una de nuestras aplicaciones usando esta tecnología. Y para hacer eso, lo primero que necesitamos hacer es definir nuestro escenario. En nuestro caso, el escenario será una aplicación nativa de la nube simple desarrollada usando una aplicación Flogo que expone un servicio REST. El primer paso que necesitamos hacer es desplegar KEDA en nuestro clúster de Kubernetes, y hay varias opciones para hacerlo: gráficos Helm, Operación o archivos YAML. En este caso, vamos a usar el enfoque de gráficos Helm. Entonces, vamos a escribir los siguientes comandos para agregar el repositorio helm y actualizar los gráficos disponibles, y luego desplegar KEDA como parte de nuestra configuración de clúster:
Después de ejecutar este comando, KEDA se despliega en nuestro clúster K8S, y al escribir el siguiente comando kubectl get all proporcionará una situación similar a esta:
Ahora, vamos a desplegar nuestra aplicación. Como ya se comentó, para hacerlo vamos a usar nuestra Aplicación Flogo, y el flujo será tan simple como este:Aplicación Flogo escuchando las solicitudes
La aplicación expone un servicio REST usando /hello como el recurso.
Las solicitudes recibidas se imprimen en la salida estándar y se devuelve un mensaje al solicitante
Una vez que tenemos nuestra aplicación desplegada en nuestra aplicación de Kubernetes, necesitamos crear un ScaledObject que sea responsable de gestionar la escalabilidad de ese componente:Configuración de ScaleObject para la aplicación Usamos Prometheus como un disparador, y debido a eso, necesitamos configurar dónde está alojado nuestro servidor Prometheus y qué consulta nos gustaría hacer para gestionar la escalabilidad de nuestro componente. En nuestro ejemplo, usaremos el flogo_flow_execution_count que es la métrica que cuenta el número de solicitudes que son recibidas por este componente, y cuando esto tiene una tasa superior a 100, lanzará una nueva réplica. Después de golpear el servicio con una Prueba de Carga, podemos ver que tan pronto como el servicio alcanza el umbral, lanza una nueva réplica para comenzar a manejar solicitudes como se esperaba.Escalado automático realizado usando métricas de Prometheus. Todo el código y los recursos están alojados en el repositorio de GitHub que se muestra a continuación: https://kubernetes.io/docs/tasks/run-application/horizontal-pod-autoscale/
Resumen
Este post ha mostrado que tenemos opciones ilimitadas para decidir las opciones de escalabilidad para nuestras cargas de trabajo. Podemos usar las métricas estándar como CPU y memoria, pero si necesitamos ir más allá, podemos usar diferentes fuentes externas de información para activar ese escalado automático.
El mercado está cambiando a una velocidad que requiere estar listo para cambiar muy rápidamente, los clientes se están volviendo cada vez más exigentes y necesitamos ser capaces de entregar lo que esperan, y para hacerlo necesitamos una arquitectura que sea lo suficientemente receptiva para poder adaptarse al ritmo que se requiere.
Las arquitecturas impulsadas por eventos (generalmente conocidas como EDA) son arquitecturas donde los eventos son la parte crucial y diseñamos componentes listos para manejar esos eventos de la manera más eficiente. Una arquitectura que está lista para reaccionar a lo que sucede a nuestro alrededor en lugar de simplemente establecer un camino específico para nuestros clientes.
Este enfoque proporciona muchos beneficios a las empresas debido a sus características, pero al mismo tiempo requiere una mentalidad diferente y un conjunto diferente de componentes en su lugar.
¿Qué es un Evento?
Comencemos por el principio. Un evento es cualquier cosa que pueda suceder y que sea importante para ti. Si piensas en un escenario donde un usuario simplemente está navegando por un sitio web de comercio electrónico, todo lo que tiene es un evento. Si llegamos al sitio de comercio electrónico porque tenía un enlace de referencia, eso es un evento.
Los eventos no solo ocurren en la vida virtual, sino también en la vida real. Una persona que simplemente entra al vestíbulo del hotel es un evento, ir frente al mostrador de recepción para hacer el check-in es otro, simplemente caminar a su habitación es otro… todo es un evento.
Los eventos en aislamiento proporcionan una pequeña pieza de información, pero juntos pueden proporcionar mucha información valiosa sobre los clientes, sus preferencias, sus expectativas y también sus necesidades. Y todo eso nos ayudará a proporcionar la experiencia más personalizada a cada uno de nuestros clientes.
EDA vs Arquitecturas Tradicionales
Las arquitecturas tradicionales funcionan en modo pull, lo que significa que un consumidor envía una solicitud a un servicio, ese servicio necesita otros componentes para hacer la lógica, obtiene la respuesta y responde. Todo está predefinido.
Los eventos funcionan de manera diferente porque operan en modo push, los eventos se envían y eso es todo, podría desencadenar una acción, muchas acciones o ninguna. Tienes una serie de componentes esperando, escuchando hasta que el evento o la secuencia de eventos que necesitan activar aparece frente a ellos y cuando lo hace, simplemente activa su lógica y como parte de esa ejecución genera uno o más eventos para poder ser consumidos nuevamente.
Modo Pull vs Push para la Comunicación.
Para poder construir una arquitectura impulsada por eventos, lo primero que necesitamos es tener componentes impulsados por eventos. Necesitamos componentes de software que se activen en función de eventos y también generen eventos como parte de su lógica de procesamiento. Al mismo tiempo, esta secuencia de eventos también se convierte en la forma de completar flujos complejos en un modo de cooperación sin la necesidad de un componente maestro que esté al tanto de todo el flujo de principio a fin.
Simplemente tienes componentes que saben que cuando sucede esto, necesitan hacer su parte del trabajo y otros componentes escucharán la salida de esos componentes y se activarán.
Este enfoque se llama Coreografía porque funciona de la misma manera en una compañía de ballet donde cada uno de los bailarines puede estar haciendo diferentes movimientos, pero cada uno de ellos sabe exactamente lo que debe hacer y todos juntos en sincronía generan la pieza completa.
Capas de una Arquitectura Impulsada por Eventos
Ahora que tenemos componentes de software que se activan usando eventos, necesitamos alguna estructura alrededor de eso en nuestra arquitectura para cubrir todas las necesidades en la gestión de los eventos, por lo que necesitamos manejar las siguientes capas:
Capas de la Arquitectura Impulsada por Eventos
Ingesta de Eventos: Necesitamos una serie de componentes que nos ayuden a introducir y recibir eventos en nuestros sistemas. Como explicamos, hay toneladas y toneladas de formas de enviar eventos, por lo que es importante que ofrezcamos flexibilidad y opciones en ese proceso. Los adaptadores y las API son cruciales aquí para asegurarse de que todos los eventos puedan ser recopilados y formar parte del sistema.
Distribución de Eventos: Necesitamos un Bus de Eventos que actúe como nuestro Océano de Eventos donde todos los eventos fluyen para poder activar todos los componentes que están escuchando ese evento.
Procesamiento de Eventos: Necesitamos una serie de componentes para escuchar todos los eventos que se envían y hacerlos significativos. Estos componentes deben actuar como guardias de seguridad: Filtran los eventos que no son importantes, también enriquecen los eventos que reciben con información de contexto de otros sistemas o fuentes de datos, y transforman el formato de algunos eventos para que sea fácil de entender para todos los componentes que están esperando esos eventos.
Acción de Eventos: Necesitamos una serie de componentes que escuchen esos eventos y estén listos para reaccionar a lo que se ve en el Bus de Eventos tan pronto como detecten que esperan comenzar a hacer su lógica y enviar la salida nuevamente al bus para ser utilizada por alguien más.
Resumen
La arquitectura impulsada por eventos puede proporcionar un ecosistema mucho más ágil y flexible donde las empresas pueden abordar los desafíos actuales para ofrecer una experiencia atractiva a los usuarios y clientes y al mismo tiempo proporcionar más agilidad a los equipos técnicos al poder crear componentes que trabajen en colaboración pero acoplados de manera flexible, haciendo que los componentes y los equipos sean más autónomos.
KubeEye te apoya en la tarea de asegurar que tu clúster esté funcionando bien y asegurar que se sigan todas tus mejores prácticas.
Kubernetes se ha convertido en la nueva norma para desplegar nuestras aplicaciones y otras opciones sin servidor, por lo que la administración de estos clústeres se ha vuelto crítica para la mayoría de las empresas, y realizar una Verificación de Salud de Kubernetes adecuada se está volviendo crítico.
Esta tarea está clara que no es una tarea fácil. Como siempre, la flexibilidad y el poder que la tecnología proporciona a los usuarios (en este caso, los desarrolladores) también viene con una compensación con la complejidad de la operación y gestión. Y esto no es una excepción a eso.
Hemos evolucionado, incluyendo opciones gestionadas que simplifican toda la configuración subyacente y la gestión de bajo nivel de la infraestructura detrás de ella. Sin embargo, hay muchas cosas que deben hacerse para que la administración del clúster tenga una experiencia feliz en el viaje de un Administrador de Kubernetes.
Muchos conceptos con los que lidiar: namespaces, límites de recursos, cuotas, ingreso, servicios, rutas, crd… Cualquier ayuda que podamos obtener es bienvenida. Y con este propósito en mente, KubeEye ha nacido.
GitHub – kubesphere/kubeeye: KubeEye aims to find various problems on Kubernetes, such as application misconfiguration, unhealthy cluster components and node problems.
KubeEye aims to find various problems on Kubernetes, such as application misconfiguration, unhealthy cluster components and node problems. – GitHub – kubesphere/kubeeye: KubeEye aims to find variou…
KubeEye es un proyecto de código abierto que ayuda a identificar algunos problemas en nuestros Clústeres de Kubernetes. Usando las palabras de sus creadores:
KubeEye tiene como objetivo encontrar varios problemas en Kubernetes, como la mala configuración de aplicaciones (usando Polaris), componentes de clúster no saludables y problemas de nodos (usando Node-Problem-Detector). Además de las reglas predefinidas, también admite reglas definidas por el usuario.
Así que podemos pensar en él como un compañero que está revisando el entorno para asegurarse de que todo esté bien configurado y saludable. Además, nos permite definir reglas personalizadas para asegurarnos de que todas las acciones que los diferentes equipos de desarrollo están realizando estén de acuerdo con los estándares predefinidos y las mejores prácticas.
Así que veamos cómo podemos incluir KubeEye para hacer una verificación de salud de nuestro entorno. Lo primero que necesitamos hacer es instalarlo. En este momento, KubeEye solo ofrece una versión para sistemas basados en Linux, por lo que si estás usando otros sistemas como yo, necesitas seguir otro enfoque y escribir los siguientes comandos:
Después de hacer eso, terminamos con un nuevo binario en nuestro PATH llamado `ke`, y este es el único componente necesario para trabajar con la aplicación. El segundo paso que necesitamos hacer para obtener más detalles sobre esos diagnósticos es instalar el componente detector de problemas de nodos.
Este componente es un componente instalado en cada nodo del clúster. Ayuda a hacer más visibles para las capas superiores los problemas relacionados con el comportamiento del clúster de Kubernetes. Este es un paso opcional, pero proporcionará datos más significativos, y para instalarlo, necesitamos ejecutar el siguiente comando.
ke install npd
Y ahora estamos listos para comenzar a verificar nuestro entorno, y el orden es tan fácil como este.
ke diag
Esto proporcionará una salida similar a esta que se compone de dos tablas diferentes. La primera se centrará en el Pod y los problemas y eventos planteados como parte del estado de la plataforma, y la otra se centrará en el resto de los elementos y tipos de objetos para los Clústeres de Kubernetes.
Salida del comando ke diag
La tabla para los problemas a nivel de pod tiene los siguientes campos:
Namespace al que pertenece el pod.
Severidad del problema.
Nombre del Pod que es responsable del problema
Hora del Evento en la que se ha planteado este evento
Razón del problema
Mensaje con la descripción detallada del problema
La segunda tabla para los otros objetos tiene la siguiente estructura:
Namespace donde se despliega el objeto que tiene un problema que está siendo detectado.
Severidad del problema.
Nombre del componente
Tipo del componente
Hora en la que se ha planteado este problema
Mensaje con la descripción detallada del problema
La salida del comando también puede mostrar otras tablas si se detectan algunos problemas a nivel de nodo.
Hoy cubrimos un tema fascinante como es la Administración de Kubernetes e introducimos una nueva herramienta que ayuda en tu tarea diaria.
¡Realmente espero que esta herramienta pueda ser añadida a tu caja de herramientas y facilite el camino para una administración feliz y saludable del Clúster de Kubernetes!
La Seguridad en el Desarrollo es uno de los grandes temas de la práctica de desarrollo actual. Todas las mejoras que obtuvimos siguiendo las prácticas de DevOps han generado muchos problemas y preocupaciones desde la perspectiva de la seguridad.
La explosión de componentes con los que los equipos de seguridad necesitan lidiar, los enfoques de contenedores y los entornos poliglotas nos han dado muchos beneficios desde la perspectiva del desarrollo y la operativa. Sin embargo, ha hecho que el lado de la seguridad sea más complejo.
Es por eso que ha habido muchos movimientos respecto al enfoque de «Shift left» e incluir la seguridad como parte del proceso de DevOps, creando el nuevo término DevSecOps que se está convirtiendo en la nueva normalidad.
DevOps tech: Shifting left on security | Google Cloud
Security is everyone’s responsibility. The 2016 State of DevOps Report (PDF) research shows that high-performing teams spend 50 percent less time remediating security issues than low-performing teams. By better integrating information security (InfoSec) objectives into daily work, teams can achieve…
Entonces, hoy lo que me gustaría traerte es un conjunto de herramientas que acabo de descubrir que están creadas con el enfoque de hacer tu vida más fácil desde la perspectiva de la seguridad en el desarrollo porque los desarrolladores también necesitan ser parte de esto y no dejar toda la responsabilidad a un equipo diferente.
Este conjunto de herramientas se llama Anchore Toolbox, y son de código abierto y de uso gratuito, como puedes ver en la página web oficial (https://anchore.com/opensource/)
Entonces, ¿qué puede proporcionarnos Anchore? Por el momento, estamos hablando de dos aplicaciones diferentes: Syft y Grype.
Syft
GitHub – anchore/syft: CLI tool and library for generating a Software Bill of Materials from container images and filesystems
CLI tool and library for generating a Software Bill of Materials from container images and filesystems – GitHub – anchore/syft: CLI tool and library for generating a Software Bill of Materials from…
Syft es una herramienta CLI y biblioteca go para generar una Lista de Materiales de Software (SBOM) a partir de imágenes de contenedores y sistemas de archivos. La instalación es tan fácil como ejecutar el siguiente comando:
curl -sSfL https://raw.githubusercontent.com/anchore/syft/main/install.sh | sh -s -- -b /usr/local/bin
Y después de hacer eso, necesitamos escribir syft para ver todas las opciones a nuestra disposición:
Menú de ayuda de Syft con todas las opciones disponibles
Entonces, en nuestro caso, lo usaré para generar una lista de materiales a partir de una imagen Docker existente de bitnami/kafka para mostrar cómo funciona esto. Necesito escribir el siguiente comando:
syft bitnami/kafka
Y después de unos segundos para cargar y analizar la imagen, obtengo como salida la lista de todos y cada uno de los paquetes que esta imagen tiene instalados y la versión de cada uno de ellos como se muestra en la imagen a continuación. Una gran cosa es que muestra no solo los paquetes del sistema operativo como lo que hemos instalado usando apk o apt, sino también otros componentes como bibliotecas java, por lo que podemos tener una lista completa de materiales para esta imagen de contenedor.
[0019] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/kafka_2.12–2.7.0-javadoc.jar’
[0019] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/kafka_2.12–2.7.0-javadoc.jar’
[0019] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/scala-java8-compat_2.12–0.9.1.jar’
[0019] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/scala-java8-compat_2.12–0.9.1.jar’
[0019] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/kafka_2.12–2.7.0-test-sources.jar’
[0019] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/kafka_2.12–2.7.0-test-sources.jar’
[0019] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/jackson-module-scala_2.12–2.10.5.jar’
[0019] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/jackson-module-scala_2.12–2.10.5.jar’
[0019] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/kafka-streams-scala_2.12–2.7.0.jar’
[0019] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/kafka-streams-scala_2.12–2.7.0.jar’
[0019] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/kafka_2.12–2.7.0-test.jar’
[0019] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/kafka_2.12–2.7.0-test.jar’
[0019] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/scala-collection-compat_2.12–2.2.0.jar’
[0019] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/scala-collection-compat_2.12–2.2.0.jar’
[0020] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/kafka_2.12–2.7.0.jar’
[0020] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/kafka_2.12–2.7.0.jar’
[0020] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/kafka_2.12–2.7.0-sources.jar’
[0020] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/kafka_2.12–2.7.0-sources.jar’
[0020] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/scala-logging_2.12–3.9.2.jar’
[0020] WARN coincidencias inesperadamente vacías para el archivo ‘/opt/bitnami/kafka/libs/scala-logging_2.12–3.9.2.jar’
NOMBRE VERSIÓN TIPO
java-archive
acl 2.2.53–4 deb
activation 1.1.1 java-archive
adduser 3.118 deb
aopalliance-repackaged 2.6.1 java-archive
apt 1.8.2.2 deb
argparse4j 0.7.0 java-archive
audience-annotations 0.5.0 java-archive
base-files 10.3+deb10u8 deb
base-passwd 3.5.46 deb
bash 5.0–4 deb
bsdutils 1:2.33.1–0.1 deb
ca-certificates 20200601~deb10u2 deb
com.fasterxml.jackson.module.jackson.module.scala java-archive
commons-cli 1.4 java-archive
commons-lang3 3.8.1 java-archive
...
Grype
GitHub – anchore/grype: A vulnerability scanner for container images and filesystems
A vulnerability scanner for container images and filesystems – GitHub – anchore/grype: A vulnerability scanner for container images and filesystems
Grype es un escáner de vulnerabilidades para imágenes de contenedores y sistemas de archivos. Es el siguiente paso porque verifica los componentes de la imagen y comprueba si hay alguna vulnerabilidad conocida.
Para instalar este componente nuevamente es tan fácil como escribir el siguiente comando:
curl -sSfL https://raw.githubusercontent.com/anchore/grype/main/install.sh | sh -s -- -b /usr/local/bin
Después de hacer eso, necesitamos escribir grype para tener el menú de ayuda con todas las opciones a nuestra disposición:
Menú de ayuda de Grype con todas las opciones disponibles
Grype funciona de la siguiente manera. Lo primero que hace es cargar la base de datos de vulnerabilidades para verificar los diferentes paquetes contra esta base de datos en busca de cualquier vulnerabilidad conocida. Después de hacer eso, sigue el mismo patrón que syft y genera la lista de materiales y verifica cada uno de los componentes en la base de datos de vulnerabilidades, y si hay una coincidencia. Simplemente proporciona el ID de la vulnerabilidad, la gravedad y, si esto se soluciona en una versión superior, proporciona la versión donde se ha solucionado esta vulnerabilidad.
Aquí puedes ver la salida respecto a la misma imagen de bitnami/kafka con todas las vulnerabilidades detectadas
grype bitnami/kafka
✔ Base de datos de vulnerabilidades [actualizada]
 ✔ Imagen cargada
 ✔ Imagen analizada
 ✔ Imagen catalogada [204 paquetes]
✔ Imagen escaneada [149 vulnerabilidades]
[0018] ERROR el emparejador falló para pkg=Pkg(type=java-archive, name=, version=): el emparejador falló al buscar por CPE pkg=’’: se requiere el nombre del producto
[0018] ERROR el emparejador falló para pkg=Pkg(type=java-archive, name=, version=): el emparejador falló al buscar por CPE pkg=’’: se requiere el nombre del producto
[0018] ERROR el emparejador falló para pkg=Pkg(type=java-archive, name=, version=): el emparejador falló al buscar por CPE pkg=’’: se requiere el nombre del producto
[0018] ERROR el emparejador falló para pkg=Pkg(type=java-archive, name=, version=): el emparejador falló al buscar por CPE pkg=’’: se requiere el nombre del producto
[0018] ERROR el emparejador falló para pkg=Pkg(type=java-archive, name=, version=): el emparejador falló al buscar por CPE pkg=’’: se requiere el nombre del producto
[0018] ERROR el emparejador falló para pkg=Pkg(type=java-archive, name=, version=): el emparejador falló al buscar por CPE pkg=’’: se requiere el nombre del producto
NOMBRE INSTALADO CORREGIDO-EN VULNERABILIDAD GRAVEDAD
apt 1.8.2.2 CVE-2011–3374 Insignificante
bash 5.0–4 CVE-2019–18276 Insignificante
commons-lang3 3.8.1 CVE-2013–1907 Media
commons-lang3 3.8.1 CVE-2013–1908 Media
coreutils 8.30–3 CVE-2016–2781 Baja
coreutils 8.30–3 CVE-2017–18018 Insignificante
curl 7.64.0–4+deb10u1 CVE-2020–8169 Media
..
Resumen
Estas simples herramientas CLI nos ayudan mucho en el necesario camino para mantener nuestro software actualizado y libre de vulnerabilidades conocidas y mejorar nuestra seguridad en el desarrollo. Además, como estas son aplicaciones CLI y también pueden ejecutarse en contenedores, es muy fácil incluirlas como parte de tu pipeline CICD para que las vulnerabilidades se puedan verificar de manera automatizada.
También proporcionaron un complemento para ser incluido en los sistemas CI/CD más utilizados, como Jenkins, Cloudbees, CircleCI, GitHub Actions, Bitbucket, Azure DevOps, y así sucesivamente.
Conocer la configuración de TIBCO BW en tiempo de ejecución se ha vuelto crítico ya que siempre necesitas saber si los últimos cambios se han aplicado o simplemente quieres verificar el valor específico de una Propiedad del Módulo como parte de tu desarrollo.
Cuando hablamos de aplicaciones desplegadas en la nube, una de las cosas clave es la Gestión de Configuración. Especialmente si incluimos en la mezcla cosas como Kubernetes, Contenedores, Sistema de Gestión de Configuración Externa, las cosas se complican.
La configuración habitual cuando hablamos de un entorno Kubernetes para la gestión de configuración es el uso de Config Maps o Spring Cloud Config.
Cuando puedes cargar la configuración en un paso separado al de desplegar la aplicación, puedes encontrarte en una situación en la que no estás seguro de cuál es la configuración en ejecución que tiene una aplicación BusinessWorks.
Para verificar la configuración de TIBCO BW hay una manera fácil de saber exactamente los valores actuales:
Solo necesitamos entrar en el contenedor para poder acceder a la consola interna de OSGI que nos permite ejecutar comandos administrativos.
Hemos hablado otras veces sobre esa API, pero en caso de que quieras echar un vistazo más profundo solo necesitas revisar este enlace:
Y uno de los comandos es lcfg que permite saber qué configuración está siendo utilizada por la aplicación que está en ejecución:
Salida de ejemplo para el comando lcfg de una Aplicación de Contenedor BusinessWorks en Ejecución
Resumen
Espero que encuentres esto interesante, y si eres uno de los que enfrenta este problema ahora, tienes información para no ser detenido por este. Si deseas enviar tus preguntas, siéntete libre de usar una de las siguientes opciones:
Twitter: Puedes enviarme una mención a @alexandrev en Twitter o un DM o incluso solo usando el hashtag #TIBFAQs que monitorearé.
Email: Puedes enviarme un correo electrónico a alexandre.vazquez en gmail.com con tu pregunta.
Instagram: Puedes enviarme un DM en Instagram a @alexandrev
Descubre las propiedades que te permitirán un uso optimizado de tu almacenamiento en disco y ahorros al almacenar tus datos de monitoreo
Prometheus se ha convertido en un componente estándar en nuestras arquitecturas en la nube y el almacenamiento de Prometheus se está convirtiendo en un aspecto crítico. Así que voy a suponer que si estás leyendo esto ya sabes qué es Prometheus. Si este no es el caso, por favor tómate tu tiempo para echar un vistazo a otros artículos que he creado:
Prometheus Monitoring for Microservices using TIBCO
We’re living a world with constant changes and this is even more true in the Enterprise Application world. I’ll not spend much time talking about things you already know, but just say that the microservices architecture approach and the PaaS solutions have been a game-changer for all enterprise integration technologies. This time I’d like to […]
Kubernetes Service Discovery for Prometheus
In previous posts, we described how to set up Prometheus to work with your TIBCO BusinessWorks Container Edition apps, and you can read more about it here. In that post, we described that there were several ways to update Prometheus about the services that ready to monitor. And we choose the most simple at that […]
Sabemos que usualmente cuando monitoreamos usando Prometheus tenemos tantos exportadores disponibles a nuestra disposición y también que cada uno de ellos expone muchas métricas muy relevantes que necesitamos para rastrear todo lo que necesitamos y que lleva a un uso muy intensivo del almacenamiento disponible si no lo gestionamos adecuadamente.
Hay dos factores que afectan esto. El primero es optimizar el número de métricas que estamos almacenando y ya proporcionamos consejos para hacerlo en otros artículos como los que se muestran a continuación:
How it optimize the disk usage in the Prometheus database?
Learn some tricks to analyze and optimize the usage that you are doing of the TSDB and save money on your cloud deployment. Photo by Markus Spiske on Unsplash In previous posts, we discussed how the storage layer worked for Prometheus and how effective it was. But in the current times, we are of cloud computing […]
El otro es cuánto tiempo almacenamos las métricas llamado el “período de retención en Prometheus.” Y esta propiedad ha sufrido muchos cambios durante las diferentes versiones. Si te gustaría ver toda la historia, por favor echa un vistazo a este artículo de Robust Perception:
How can you control how much history Prometheus keeps?
Las principales propiedades que puedes configurar son las siguientes:
storage.tsdb.retention.time: Número de días para almacenar las métricas por defecto a 15d. Esta propiedad reemplaza la obsoleta storage.tsdb.retention.
storage.tsdb.retention.size: Puedes especificar el límite de tamaño a utilizar. Este no es un límite estricto sino un mínimo, así que por favor define algún margen aquí. Unidades soportadas: B, KB, MB, GB, TB, PB, EB. Ej: “512MB”. Esta propiedad es experimental hasta ahora como puedes ver en la documentación oficial:
¿Qué tal configurar esta configuración en el operador para Kubernetes? En ese caso, también tienes opciones similares disponibles en el archivo de configuración values.yaml para el chart como puedes ver en la imagen a continuación:
values.yml para el Helm Chart del Operador de Prometheus
Esto debería ayudarte a obtener un despliegue optimizado de Prometheus que asegure todas las características que tiene Prometheus pero al mismo tiempo un uso óptimo de los recursos a tu disposición.
Además de eso, también deberías revisar las opciones de Servicio Gestionado que algunos proveedores tienen respecto a Prometheus, como los Servicios Gestionados de Amazon para Prometheus, como puedes ver en el enlace a continuación:
Amazon Prometheus Service to Provide More Availability to Your Monitoring Solution
Learn what Amazon Managed Service for Prometheus provides and how you can benefit from it. Photo by Casey Horner on Unsplash Monitoring is one of the hot topics when we talk about cloud-native architectures. Prometheus is a graduated Cloud Native Computing Foundation (CNCF) open-source project and one of the industry-standard solutions when it comes to monitoring your […]
Aprende sobre el nuevo sistema de agregación de logs escalable horizontalmente, altamente disponible y multi-inquilino inspirado en Prometheus que puede ser la mejor opción para tu arquitectura de registro
Loki vs ELK es algo que estás leyendo y escuchando cada vez más a menudo ya que desde hace algún tiempo hay un aumento en la disputa por convertirse en el estándar de facto para las arquitecturas de agregación de logs.
Cuando hablamos de Arquitectura Nativa de la Nube, la agregación de logs es algo clave que necesitas considerar. Las viejas prácticas que seguimos en el enfoque de máquinas virtuales on-premises para el registro ya no son válidas.
Ya cubrimos este tema en mi publicación anterior que te recomiendo echar un vistazo en caso de que no la hayas leído aún, pero este no es el tema de hoy.
Three reasons why you need a Log Aggregation Architecture today
Log Aggregation are not more a commodity but a critical component in container-based platforms Photo by Olav Ahrens Røtne on Unsplash Log Management doesn’t seem like a very fantastic topic. It is not the topic that you see and says: “Oh! Amazing! This is what I was dreaming about my whole life”. No, I’m aware that […]
Elasticsearch como el núcleo y las diferentes pilas derivadas como ELK/EFK han ganado popularidad en los últimos años, siendo prácticamente la opción predeterminada de código abierto cuando hablamos de agregación de logs y una de las opciones. Los principales proveedores de nube pública también han adoptado esta solución como parte de su propia oferta, como lo proporciona el Servicio de Elasticsearch de Amazon.
Pero Elasticsearch no es perfecto. Si ya lo has usado, probablemente lo sepas. Aún así, debido a que sus características son tan impresionantes, especialmente en las capacidades de búsqueda e indexación, ha sido el tipo de líder hoy en día. Pero otros temas como el uso del almacenamiento, la cantidad de poder que necesitas para manejarlo y la arquitectura con diferentes tipos de nodos (maestro, datos, ingestor) aumentan su complejidad para casos cuando necesitamos algo más pequeño.
Y para llenar este vacío es donde llega nuestro personaje principal para la publicación de hoy: Loki o Grafana Loki.
Loki es un sistema de gestión de logs creado como parte del proyecto Grafana, y ha sido creado con un enfoque diferente en mente que Elasticsearch.
Loki es un sistema de agregación de logs escalable horizontalmente, altamente disponible y multi-inquilino inspirado en Prometheus. Está diseñado para ser muy rentable y fácil de operar. No indexa el contenido de los logs, sino un conjunto de etiquetas para cada flujo de logs.
Así que, como podemos leer en la definición de su propia página arriba, cubre varios temas interesantes en comparación con Elasticsearch:
En primer lugar, aborda algunos de los puntos de dolor habituales para los clientes de ELK: Es muy rentable y fácil de operar.
Claramente dice que el enfoque no es el mismo que ELK, no vas a tener un índice completo de la carga útil para los eventos, sino que se basa en diferentes etiquetas que puedes definir para cada flujo de logs.
Prometheus inspira eso, lo cual es crítico porque permitió la idea de usar trazas de logs como métricas para potenciar nuestras soluciones de monitoreo.
Comencemos con las preguntas iniciales cuando mostramos una nueva tecnología interesante y nos gustaría comenzar a probarla.
¿Cómo puedo instalar Loki?
Loki se distribuye en diferentes versiones para ser instalado en tu entorno de la manera que lo necesites.
SaaS: proporcionado como parte de la solución de alojamiento de Grafana Cloud.
On-Premises: Proporcionado como un binario normal para descargar y ejecutar en modo on-premises.
Nube: Proporcionado como una imagen de Docker o incluso un Helm Chart para ser desplegado en tu entorno basado en Kubernetes.
Los equipos de GrafanaLabs también proporcionan Soporte Empresarial para Loki si deseas usarlo en modo de producción en tu empresa. Aún así, al mismo tiempo, todo el código está licenciado usando la Licencia Apache 2.0, por lo que puedes echar un vistazo a todo el código y contribuir a él.
En cuanto a la arquitectura, es muy similar a la pila ELK/EFK y sigue el mismo enfoque de “coleccionistas” e “indexadores” como tiene ELK:
Loki en sí mismo es el nodo central de la arquitectura responsable de almacenar las trazas de logs y sus etiquetas y proporciona una API para buscar entre ellas basándose en su propio lenguaje LogQL (un enfoque similar al PromQL de Prometheus).
promtail es el componente agente que se ejecuta en el borde obteniendo todas esas trazas de logs que necesitamos que pueden estar ejecutándose en una máquina on-prem o en un modo DaemonSet en nuestro propio clúster de Kubernetes. Desempeña el mismo papel que Logstash/Fluent-bit/Fluentd en la pila ELK/EFK. Promtail proporciona el modo de plugin habitual para filtrar y transformar nuestras trazas de logs como lo hacen las otras soluciones. Al mismo tiempo, proporciona una característica interesante para convertir esas trazas de logs en métricas de Prometheus que pueden ser recolectadas directamente por tu servidor Prometheus.
Grafana es la interfaz de usuario para toda la pila y desempeña un papel similar al de Kibana en la pila ELK/EFK. Grafana, entre otros plugins, proporciona integración directa con Loki como una fuente de datos para explorar esas trazas e incluirlas en los paneles.
Resumen
Grafana Loki puede ser una gran solución para tu arquitectura de registro para cubrir dos puntos: Proporcionar una solución de agregación de logs ligera para tu entorno y al mismo tiempo habilitar tus trazas de logs como una fuente para tus métricas, permitiéndote crear métricas detalladas, más orientadas al negocio que se utilizan en tus paneles y tus sistemas de monitoreo.