Descubre SARChart y kSAR como utilidades críticas para ser parte de tu cinturón de herramientas para administración o resolución de problemas
Hubo un tiempo en que no teníamos proveedores de nube pública que nos proporcionaran una variedad de tipos de servicios y toda una plataforma y experiencia unificada, cubriendo todos los aspectos de nuestras necesidades técnicas cuando hablábamos de un entorno de TI y las métricas de sysstat eran clave allí.
Hubo un tiempo en que AWS Cloud Watch, Azure Monitor, Prometheus no existían, y necesitábamos lidiar con servidores Linux sin un portal completo que proporcionara todas las métricas que podríamos necesitar.
Hubo un tiempo… que todavía es el presente para muchos clientes y organizaciones en todo el mundo y aún necesitan lidiar con esta situación, y probablemente te enfrentes a esta situación ahora o incluso en el futuro. Así que, veamos qué podemos hacer al respecto.
Presentando sysstat
Durante varias décadas, la forma estándar de extraer las métricas de uso de un servidor Linux fue sysstat. Basado en las palabras de su página web oficial, esto es lo que es sysstat:
Las utilidades sysstat son una colección de herramientas de monitoreo de rendimiento para Linux. Estas incluyen sar, sadf, mpstat, iostat, tapestat, pidstat, cifsiostat y herramientas sa
Sysstat es un software antiguo pero confiable que su propietario continúa actualizando incluso hoy… pero manteniendo la misma página web desde el principio 🙂
Sysstat es antiguo pero poderoso, y tiene tantas opciones que me han salvado la vida con muchos clientes y proporcionado mucha información útil que necesitaba en ese momento. Pero hoy, voy a hablar sobre una utilidad específica de todo el conjunto, que es sar.
sar es el comando para poder consultar las métricas de rendimiento de una máquina existente. Simplemente escribiendo el comando sar es suficiente para comenzar a ver cosas impresionantes. Eso te dará las métricas de CPU para todo el día para cada una de las CPUs que tiene tu máquina y también se dividirá dependiendo del tipo de uso (usuario, sistema, inactivo, todo).
Ejecución del comando sar en una máquina local
Pero estas métricas no son lo único que puedes obtener. Otras opciones disponibles
sar -r: Proporciona métricas de memoria
sar -q: Proporciona las métricas de carga.
sar -n: Proporciona las métricas de red.
sar -A: Proporciona TODAS las métricas.
sar -f /var/log/sysstat/sa[día-del-mes]: Proporcionará métricas para el día del mes en lugar del día actual.
Hay muchas más opciones que puedes usar en tu día a día, así que si necesitas algo concreto, echa un vistazo a la página del manual para el comando sar:
sar(1) – Linux man page
The sar command writes to standard output the contents of selected cumulative activity counters in the operating system. The accounting system, based on …
Pero todos somos personas visuales, ¿verdad? Es cierto que ver tendencias y evoluciones es más complejo en modo texto y también ver solo datos diarios a la vez. Así que echa un vistazo a las opciones para manejar ese desafío:
Frontend desarrollado en Java usando la biblioteca Swing para representar visualmente los datos de sar. Es portátil, por lo que necesitas el archivo JAR para ejecutarlo. Y puedes invocarlo de varias maneras:
Proporcionando el archivo que obtuviste de una máquina en la que ejecutaste el comando sar.
Conectando mediante SSH a una máquina remota y ejecutando el comando que necesitas.
Visualización gráfica de las métricas de sar usando kSAR
SARChart
¿Qué pasa cuando estás en una máquina en la que no tienes los derechos para instalar ninguna aplicación, incluso una portátil como kSAR, o tal vez solo tienes tu tableta disponible? En ese caso, tenemos SARChart.
SARChart es una aplicación web que proporciona un análisis gráfico de los archivos sar. Así que solo necesitas subir el archivo para obtener un análisis gráfico completo y bien presentado de tus datos cubriendo todos sus aspectos. Además, todo el trabajo se realiza a nivel del cliente sin enviar ninguno de tus datos a ningún servidor.
Análisis de uso de CPU proporcionado por SARChart
Resumen
Espero que encuentres estas herramientas interesantes si no las conocías, y también espero que puedan ayudarte con tu trabajo diario o al menos ser parte de tu conjunto de herramientas para estar a tu disposición cuando las necesites.
El servicio Mesh Linkerd patrocinado por CNCF proporciona muchas características necesarias en las arquitecturas de microservicios actuales.
Si estás leyendo esto, probablemente ya estés al tanto de los desafíos que vienen con una arquitectura de microservicios. Podría ser porque estás leyendo sobre ellos o incluso porque los estás enfrentando ahora mismo en tu propia piel.
Uno de los desafíos más comunes es la red y la comunicación. Con la eclosión de muchos componentes que necesitan comunicación y el enfoque efímero de los desarrollos nativos de la nube, muchas características nuevas son una necesidad cuando en el pasado eran solo un «agradable de tener».
Conceptos como el registro de servicios y el descubrimiento de servicios, la autenticación de servicios, las políticas de enrutamiento dinámico y los patrones de disyuntor ya no son cosas que todas las empresas geniales están haciendo, sino algo básico para dominar la nueva arquitectura de microservicios como parte de una plataforma de arquitectura nativa de la nube, y aquí es donde el proyecto Service Mesh está aumentando su popularidad como una solución para la mayoría de estos desafíos y proporcionando estas características que se necesitan.
Si recuerdas, hace mucho tiempo, ya cubrí ese tema para presentar Istio como una de las opciones que tenemos:
Integrating Istio with BWCE Applications
Introduction Services Mesh is one the “greatest new thing” in our PaaS environments. No matter if you’re working with K8S, Docker Swarm, pure-cloud with EKS or AWS, you’ve heard and probably tried to know how can be used this new thing that has so many advantages because it provides a lot of options in handling […]
Pero este proyecto creado por Google e IBM no es la única opción que tienes para proporcionar esas capacidades. Como parte de la Cloud Native Computing Foundation (CNCF), el proyecto Linkerd proporciona características similares.
Cómo instalar Linkerd
Para comenzar a usar Linkerd, lo primero que necesitamos hacer es instalar el software y para hacerlo. Necesitamos hacer dos instalaciones, una en el servidor de Kubernetes y otra en el host.
Para instalar en el host, necesitas ir a la página de lanzamientos y descargar la edición para tu sistema operativo e instalarla.
Estoy usando un sistema basado en Windows en mi ejemplo, así que uso chocolatey para instalar el cliente. Después de hacerlo, puedo ver la versión del CLI escribiendo el siguiente comando:
linkerd version
Y obtendrás una salida que dirá algo similar a esto:
PS C:WINDOWSsystem32> linkerd.exe version
Client version: stable-2.8.1
Server version: unavailable
Ahora necesitamos hacer la instalación en el servidor de Kubernetes, y para hacerlo, usamos el siguiente comando:
linkerd install | kubectl apply -f -
Y obtendrás una salida similar a esta:
PS C:WINDOWSsystem32> linkerd install | kubectl apply -f -
namespace/linkerd created
clusterrole.rbac.authorization.k8s.io/linkerd-linkerd-identity created
clusterrolebinding.rbac.authorization.k8s.io/linkerd-linkerd-identity created
serviceaccount/linkerd-identity created
clusterrole.rbac.authorization.k8s.io/linkerd-linkerd-controller created
clusterrolebinding.rbac.authorization.k8s.io/linkerd-linkerd-controller created
serviceaccount/linkerd-controller created
clusterrole.rbac.authorization.k8s.io/linkerd-linkerd-destination created
clusterrolebinding.rbac.authorization.k8s.io/linkerd-linkerd-destination created
serviceaccount/linkerd-destination created
role.rbac.authorization.k8s.io/linkerd-heartbeat created
rolebinding.rbac.authorization.k8s.io/linkerd-heartbeat created
serviceaccount/linkerd-heartbeat created
role.rbac.authorization.k8s.io/linkerd-web created
rolebinding.rbac.authorization.k8s.io/linkerd-web created
clusterrole.rbac.authorization.k8s.io/linkerd-linkerd-web-check created
clusterrolebinding.rbac.authorization.k8s.io/linkerd-linkerd-web-check created
clusterrolebinding.rbac.authorization.k8s.io/linkerd-linkerd-web-admin created
serviceaccount/linkerd-web created
customresourcedefinition.apiextensions.k8s.io/serviceprofiles.linkerd.io created
customresourcedefinition.apiextensions.k8s.io/trafficsplits.split.smi-spec.io created
clusterrole.rbac.authorization.k8s.io/linkerd-linkerd-prometheus created
clusterrolebinding.rbac.authorization.k8s.io/linkerd-linkerd-prometheus created
serviceaccount/linkerd-prometheus created
clusterrole.rbac.authorization.k8s.io/linkerd-linkerd-proxy-injector created
clusterrolebinding.rbac.authorization.k8s.io/linkerd-linkerd-proxy-injector created
serviceaccount/linkerd-proxy-injector created
secret/linkerd-proxy-injector-tls created
mutatingwebhookconfiguration.admissionregistration.k8s.io/linkerd-proxy-injector-webhook-config created
clusterrole.rbac.authorization.k8s.io/linkerd-linkerd-sp-validator created
clusterrolebinding.rbac.authorization.k8s.io/linkerd-linkerd-sp-validator created
serviceaccount/linkerd-sp-validator created
secret/linkerd-sp-validator-tls created
validatingwebhookconfiguration.admissionregistration.k8s.io/linkerd-sp-validator-webhook-config created
clusterrole.rbac.authorization.k8s.io/linkerd-linkerd-tap created
clusterrole.rbac.authorization.k8s.io/linkerd-linkerd-tap-admin created
clusterrolebinding.rbac.authorization.k8s.io/linkerd-linkerd-tap created
clusterrolebinding.rbac.authorization.k8s.io/linkerd-linkerd-tap-auth-delegator created
serviceaccount/linkerd-tap created
rolebinding.rbac.authorization.k8s.io/linkerd-linkerd-tap-auth-reader created
secret/linkerd-tap-tls created
apiservice.apiregistration.k8s.io/v1alpha1.tap.linkerd.io created
podsecuritypolicy.policy/linkerd-linkerd-control-plane created
role.rbac.authorization.k8s.io/linkerd-psp created
rolebinding.rbac.authorization.k8s.io/linkerd-psp created
configmap/linkerd-config created
secret/linkerd-identity-issuer created
service/linkerd-identity created
deployment.apps/linkerd-identity created
service/linkerd-controller-api created
deployment.apps/linkerd-controller created
service/linkerd-dst created
deployment.apps/linkerd-destination created
cronjob.batch/linkerd-heartbeat created
service/linkerd-web created
deployment.apps/linkerd-web created
configmap/linkerd-prometheus-config created
service/linkerd-prometheus created
deployment.apps/linkerd-prometheus created
deployment.apps/linkerd-proxy-injector created
service/linkerd-proxy-injector created
service/linkerd-sp-validator created
deployment.apps/linkerd-sp-validator created
service/linkerd-tap created
deployment.apps/linkerd-tap created
configmap/linkerd-config-addons created
serviceaccount/linkerd-grafana created
configmap/linkerd-grafana-config created
service/linkerd-grafana created
deployment.apps/linkerd-grafana created
Ahora podemos verificar que la instalación se ha realizado correctamente usando el comando:
linkerd check
Y si todo se ha hecho correctamente, obtendrás una salida como esta:
PS C:WINDOWSsystem32> linkerd check
kubernetes-api
--------------
√ can initialize the client
√ can query the Kubernetes API
kubernetes-version
------------------
√ is running the minimum Kubernetes API version
√ is running the minimum kubectl version
linkerd-existence
-----------------
√ 'linkerd-config' config map exists
√ heartbeat ServiceAccount exist
√ control plane replica sets are ready
√ no unschedulable pods
√ controller pod is running
√ can initialize the client
√ can query the control plane API
linkerd-config
--------------
√ control plane Namespace exists
√ control plane ClusterRoles exist
√ control plane ClusterRoleBindings exist
√ control plane ServiceAccounts exist
√ control plane CustomResourceDefinitions exist
√ control plane MutatingWebhookConfigurations exist
√ control plane ValidatingWebhookConfigurations exist
√ control plane PodSecurityPolicies exist
linkerd-identity
----------------
√ certificate config is valid
√ trust anchors are using supported crypto algorithm
√ trust anchors are within their validity period
√ trust anchors are valid for at least 60 days
√ issuer cert is using supported crypto algorithm
√ issuer cert is within its validity period
√ issuer cert is valid for at least 60 days
√ issuer cert is issued by the trust anchor
Luego podemos ver el panel de Linkerd usando el siguiente comando:
linkerd dashboard
Página web inicial del panel después de una instalación limpia de Linkerd
Despliegue de las aplicaciones
Usaremos las mismas aplicaciones que usamos hace algún tiempo para desplegar istio, así que si quieres recordar lo que están haciendo, necesitas mirar de nuevo ese artículo.
Para desplegar, necesitas tener tus imágenes de docker subidas a un registro de docker, y usaré Amazon ECR como el repositorio de docker que voy a usar.
Así que necesito construir y subir esas imágenes con los siguientes comandos:
Y si alcanzamos el endpoint, obtuvimos la respuesta esperada del proveedor.
Respuesta de muestra proporcionada por el proveedor
Y en el panel, podemos ver las estadísticas del proveedor:
Panel de Linkerd mostrando las estadísticas del flujo
Además, Linkerd por defecto proporciona un panel de Grafana donde puedes ver más métricas, puedes llegar allí usando el enlace de grafana que tiene el panel.
Enlace de Grafana en el Panel de Linkerd
Cuando entras, podrías ver algo como el panel que se muestra a continuación:
Panel de Grafana mostrando las estadísticas de linkerd
Resumen
Con todo este proceso, hemos visto lo fácil que podemos desplegar un servicio mesh de linkerd en nuestro clúster de Kubernetes y cómo las aplicaciones pueden integrarse e interactuar con ellos. En los próximos posts, profundizaremos en las características más avanzadas que nos ayudarán en los nuevos desafíos que vienen con la arquitectura de Microservicios.
Transmisión de Eventos, API y Datos son los tres mosqueteros que cubren todos los aspectos de dominar la integración en la nube.
Foto de Simon Rae en Unsplash La Integración de Aplicaciones Empresariales ha sido uno de los temas más desafiantes en el panorama de TI desde el principio de los tiempos. Tan pronto como el número de sistemas y aplicaciones en grandes corporaciones comenzó a crecer, esto se convirtió en un problema que debíamos abordar. La eficiencia de este proceso también definirá qué empresas tendrán éxito y cuáles fracasarán, ya que la cooperación entre aplicaciones se vuelve crítica para responder al ritmo que el negocio demanda. Usualmente me gusta usar la «analogía de la carretera» para definir esto:
No importa si tienes los autos más rápidos, si no tienes carreteras adecuadas no llegarás a ninguna parte
Esta situación genera muchas inversiones por parte de las empresas. Además, se lanzaron muchos proveedores y productos para apoyar esa situación. Algunas soluciones están comenzando a emerger: EAI, ESB, SOA, Middleware, Plataformas de Integración Distribuida, solución Nativa de la Nube e iPaaS. Cada uno de los enfoques proporciona una solución para los desafíos existentes. A medida que el resto de la industria evolucionaba, las soluciones cambiaron para adaptarse a la nueva realidad (contenedores, microservicios, DevOps, API-led, Event-Driven..) Entonces, ¿cuál es la situación hoy? Hoy en día está extendida la idea errónea de que la integración es lo mismo que API y también que API es HTTP asincrónico basado en (REST, gRPC, GraphQL) API. Pero es mucho más que esto.Foto de Tolga Ulkan en Unsplash
1.- API
API-led es clave para la solución de integración, especialmente enfocándose en el enfoque filosófico detrás de ella. Cada componente que creamos hoy se crea con la colaboración en mente para trabajar con componentes existentes y futuros para beneficiar al negocio de una manera fácil y ágil. Esto trasciende completamente la discusión del protocolo. API cubre todo tipo de soluciones desde API REST existentes hasta AsyncAPI para cubrir la API basada en eventos.
2.- Transmisión de Eventos
La comunicación asincrónica es necesaria porque los patrones y los requisitos cuando se habla de grandes empresas y diferentes aplicaciones hacen que esto sea esencial. Requisitos como el enfoque pub-sub para aumentar la independencia entre servicios y aplicaciones, control de flujo para gestionar la ejecución de flujos de alta demanda que pueden exceder la limitación para aplicaciones, especialmente cuando se habla de soluciones SaaS. Entonces, puedes pensar que esta es una visión muy opinada, pero al mismo tiempo, esto es algo que la mayoría de los proveedores en este espacio han realizado basándose en sus acciones:
AWS lanza SNS/SQS, su primer sistema de mensajería, como su única solución.
Nov 2017 AWS lanza Amazon MQ, otro sistema de mensajería en cola para cubrir los escenarios que SQS no puede cubrir.
May 2019 AWS lanza Amazon MSK, un servicio gestionado para soluciones Kafka para proporcionar capacidades de distribución y procesamiento de datos en streaming.
Y esa situación es porque cuando nos alejamos de aplicaciones más pequeñas, cuando estamos migrando de un enfoque monolítico a una aplicación de microservicios, se necesitan más patrones y más requisitos, y aquí es donde las soluciones de integración han demostrado en el pasado que esto es crítico para las soluciones de integración.
3.- Integración de Datos
Usualmente, cuando hablamos de integración, hablamos de Integración de Aplicaciones Empresariales porque tenemos este sesgo del pasado. Incluso yo uso este término para cubrir este tema, EAI, porque usualmente nos referimos a estas soluciones. Pero desde los últimos años, estamos más enfocados en la distribución de datos en la empresa en lugar de cómo las aplicaciones se integran porque lo que realmente importa son los datos que están intercambiando y cómo podemos transformar estos datos en bruto en conocimientos que podamos usar para conocer mejor a nuestros clientes u optimizar nuestros procesos o descubrir nuevas oportunidades basadas en eso. Hasta hace poco, esta parte se manejaba aparte de las soluciones de integración. Probablemente dependías de un ETL (Extract-Transform-Load) enfocado que ayuda a mover los datos de una base de datos a otra o a un tipo diferente de almacenamiento como un Data Warehouse para que tus Científicos de Datos puedan trabajar con ellos. Pero nuevamente, la agilidad ha hecho que esto necesite cambiar, y todos los principios de integración en términos de proporcionar más agilidad al negocio también se aplican a cómo intercambiamos datos. Tratamos de evitar el movimiento técnico de los datos y tratamos de facilitar el acceso y la organización adecuada de estos datos. La Virtualización de Datos y la Transmisión de Datos son las capacidades centrales que abordan y manejan esos desafíos proporcionando una solución optimizada para cómo se distribuyen los datos.
Resumen
Mi principal expectativa con este artículo es hacerte consciente de que cuando piensas en integrar tu aplicación, esto es mucho más que la API REST que estás exponiendo, tal vez usando algún API Gateway, y las necesidades pueden ser muy diferentes. Cuanto más fuerte sea tu plataforma de integración, más fuerte será tu negocio.
SetApp proporciona un conjunto fantástico de herramientas que pueden aumentar tu productividad como Desarrollador de Software.
Acabo de cambiar la laptop PC que usé extensamente durante los últimos años por una nueva Macbook Pro la semana pasada, y he entrado en un nuevo mundo. He usado entornos OS X en el pasado. Tuve mi primer Macbook en 2008 y mi segundo en 2016, así que no soy nuevo en el ecosistema OS X, pero incluso con eso, las cosas cambian rápidamente en la industria de las aplicaciones, especialmente en los últimos cuatro años.
Así que, cuando me enfrento a la pantalla de inicio de sesión de Big Sur frente a mí, me pregunté cómo puedo equiparme, y recordé SetApp. Descubrí SetApp hace mucho tiempo porque uno de los principales podcasters que escucho, Emilio Cano, es un fan muy entusiasta de SetApp y utiliza cualquier oportunidad que tiene para hablar sobre sus beneficios.
Así que decidí darle una oportunidad, y no podría estar más feliz de haberlo hecho. Pero antes de empezar a hablar sobre las aplicaciones, me gustaría dar un resumen de lo que es SetApp, y usaré sus propias palabras de su sitio web oficial:
Setapp es un conjunto de aplicaciones multiplataforma, resolviendo tus tareas diarias. Mantente en tu flujo, en cualquier lugar.
Así que, es como un Netflix para aplicaciones, pagas una suscripción mensual, y tienes acceso a aplicaciones de pago automáticamente, y siguen agregando nuevas a su repositorio para que puedas usarlas.
Como Desarrollador de Software, trato de enfocar esta publicación en las aplicaciones que me ayudan en mi trabajo diario, y aquí están las tres (3) que más me ayudan:
1.- Shimo — Un Cliente VPN Asombroso
En estos días de trabajo remoto, necesitaremos conectarnos a varias VPN cada día para acceder al entorno de tu empresa o incluso al entorno del cliente. Si eres como yo, que trabajas diariamente para varios clientes, cambiar de una VPN de cliente a otra es tu tarea diaria, y si puedes hacerlo rápido, optimizas tu tiempo.
Shimo es un cliente VPN que soporta todos los principales protocolos que las empresas utilizan: Cisco, Juniper, OpenVPN… todo lo que puedas necesitar.
Opciones de VPN que Shimo te proporciona (captura de pantalla por el autor)
Puedes conectarte a más de una VPN si no se superponen, y también puedes acceder a una forma rápida de conectar o desconectar cualquier VPN desde la barra de menú.
2.- Paste — El Portapapeles Definitivo
Esta es una aplicación que es clave para cualquier desarrollador y para cualquier persona que use una computadora. Paste es simplemente como debería ser el portapapeles. Es un portapapeles mejorado con un historial, para que puedas retroceder y seleccionar algo que copiaste ayer y necesitas recuperar.
Y seamos honestos, como Desarrollador de Software, uno de nuestros principales trucos es el CTRL+C, CTRL+V. Puede ser necesario para todo: un fragmento de código que un colega compartió contigo o el comando UNIX que siempre olvidas o recuperar el nombre de usuario que alguien compartió contigo usando un correo electrónico o Slack.
Captura de pantalla de Paste tomada por el autor
3.- DevUtils
Esta es una elección clara. Una herramienta que se llama DevUtils debería estar en esta lista. Pero, ¿qué es DevUtils? Es una colección de todas esas herramientas que siempre buscas en internet para hacer tareas simples pero habituales.
Tareas como codificar o decodificar desde base64, un probador de expresiones regulares, convertidor de tiempo UNIX, formateador de JSON, depurador de JWT, y mucho más… ¿Cuántas veces buscas en Google para hacer una de estas tareas? ¿Cuánto tiempo puedes ahorrar simplemente teniendo eso en tu dock todo el tiempo? La respuesta es simple: ¡mucho!
Captura de pantalla de DevUtils tomada por el Autor
Resumen
Hay muchas más aplicaciones en el catálogo de SetApp. Al escribir este artículo, el número asciende a 210 aplicaciones que cubren todos los aspectos de tu vida, incluyendo una de las aplicaciones más vendidas en la App Store. Pero me gustaría centrarme en las que más uso en mi vida como Desarrollador de Software, y si eres como yo, ¡te parecerán increíbles!
Aprende las principales razones detrás de un estado Deteriorado y cómo puedes realizar la resolución de problemas para identificar y resolver el error.
Este es otro post de la serie #TIBFAQS. Para recordarte de qué se trata todo esto, puedes enviar tus preguntas sobre problemas o dudas de desarrollo de TIBCO e intentar proporcionar una respuesta aquí para tratar de ayudar a la comunidad de desarrolladores de TIBCO.
Así que hoy voy a comenzar con uno de los problemas más comunes cuando trabajamos con BusinessWorks, y es cuando voy a desplegar mi aplicación o probarla localmente, y obtengo este rastro de registro y nada después de eso: Estado Deteriorado de TIBCO BW.
Mensaje de error de estado deteriorado
Esta es una de las situaciones habituales para un desarrollador junior de BusinessWorks y una de las razones por las que pasas más tiempo haciendo resolución de problemas. Vamos a obtener algunos trucos hoy, para que este mensaje nunca más te detenga en tu camino a producción.
¿Cuál es la causa de este error?
Este error significa que el tiempo de ejecución de BusinessWorks no puede cumplir con todas las dependencias entre los componentes para poder iniciar. Como probablemente sepas, en BusinessWorks cada uno de los componentes de las aplicaciones se gestiona de manera independiente y se referencian entre sí.
Por ejemplo, la Aplicación depende del Módulo de Aplicación y el Módulo Compartido. El módulo de Aplicación puede tener una dependencia de una Conexión JMS y así sucesivamente.
Situaciones que pueden provocar este error
Veamos ahora la situación que puede provocar este error y cómo resolverlo.
1.- Módulo faltante o versiones incompatibles
Una situación habitual que puede llevar a este problema es la falta de módulos o versiones incompatibles de los módulos. En ese caso, el componente referenciable esperará un módulo o una versión específica de un módulo para iniciarse. Sin embargo, este módulo falta o está iniciando otra versión.
2.- Conexiones compartidas no válidas
Otra opción puede ser si algunos de los componentes requieren establecer la conexión con otras tecnologías como conexiones JDBC, conexiones JMS, conexiones KAFKA u otro de los más de 200 conectores disponibles.
3.- Componente de Inicio faltante en los Descriptores de Módulo
El último de los sospechosos habituales aquí es cuando tienes un componente de Inicio en los Descriptores de Módulo, pero este proceso no está disponible dentro del archivo EAR que estás desplegando. Esa dependencia nunca se satisface, y eso lleva a un estado Deteriorado ilimitado.
¿Cómo detectar qué componente está faltando?
Para ayudarte en el proceso de detectar en qué situación te encuentras, tienes una herramienta increíble a tu disposición que es el comando la de la Interfaz de Consola OSGi.
Este comando nos ayuda a listar las aplicaciones desplegadas en este AppNode o contenedor específico y nos da los detalles de ellas, incluyendo la razón de una situación Deteriorada.
Cómo ejecutar la consola OSGi depende de tu modelo de despliegue, pero puedes leer toda la información al respecto en el siguiente enlace:
403 Forbidden
Resumen
Espero que encuentres esto interesante para resolver el estado Deteriorado de TIBCO BW en tus aplicaciones, y si eres uno de los que enfrenta este problema ahora, tienes información para no ser detenido por este. Si deseas enviar tus preguntas, siéntete libre de usar una de las siguientes opciones:
Twitter: Puedes enviarme una mención a @alexandrev en Twitter o un DM o incluso solo usar el hashtag #TIBFAQs que monitorearé.
Email: Puedes enviarme un correo electrónico a alexandre.vazquez en gmail.com con tu pregunta.
Instagram: Puedes enviarme un DM en Instagram a @alexandrev
Nunca he sido corredor en mi vida hasta hace poco. Siempre fui un chico de deportes de equipo. Siempre disfruto de la competencia y el trabajo en equipo, así que correr no era lo mío, pero en algún momento, necesitaba hacer algo para cambiar mi vida.
La razón de eso es clara, después de ganar más de 20 kg en mis días de universidad y vida adulta, estaba afectando mi salud tanto física como mentalmente.
Ahora, después de dos maratones, varias medias maratones y muchas carreras de 10k, puedo contarte mi experiencia y especialmente algunos de los beneficios inesperados después de unirme a este movimiento que probablemente no conoces aún si no estás en esto o si ya lo estás, espero que leer esto pueda poner una sonrisa en tu cara.
#1 Tendrás Tu Propio Momento Para Encontrarte A Ti Mismo
Correr es un deporte que puedes practicar por ti mismo y prácticamente en cualquier lugar. Lo único que necesitas para empezar es un par de zapatillas y tu motivación para salir y empezar a correr.
Eso significa que es cuando estás solo en un momento privado con tu propia mente. Descubrí que este es un gran momento para organizar mi cabeza. No solo para liberar todo el estrés de mi vida diaria y abrazar este momento mío para ser más feliz, sino también para ser más saludable.
No tengo una rutina clara respecto a este tema o alguna técnica de meditación que haga. Depende de lo que necesite en cada momento.
Algunos días necesito escuchar música para liberar todo después de un mal día en el trabajo o para cargar mis baterías para comenzar mi día completamente, o necesito escuchar mis podcasts de una manera íntima en la que pueda concentrarme mucho más en su contenido de lo que probablemente pueda hacer en mi vida normal.
Pero otros días, uso ese tiempo para concentrarme en resolver un problema que tengo en el trabajo (cómo resolver este problema de producción, cómo implementar esta característica que no tenía clara, cómo enfocar esta presentación que necesito hacer…) o incluso para pensar en mi vida y metas para el futuro.
#2 Serás Parte De Una Comunidad
Los corredores son parte de la misma comunidad, y nadie puede cambiar eso. Incluso personas como yo que siempre corren solas y no son parte de ningún club de corredores que se reúnen para hacer el entrenamiento definido pertenecen a esta hermandad.
Es una experiencia extraña cuando te levantas para hacer nuestra carrera matutina, y te encuentras por unos segundos con otra persona haciendo lo mismo que tú. Es una conexión extraña que sientes con esa persona. Probablemente incluso lo/la saludes aunque no lo/la conozcas solo porque ambos saben que son parte del mismo club secreto y comparten algo en común.
Esto es aún mejor si te unes a otras comunidades de corredores como Publicaciones de Corredores, Podcast o Club de Corredores, como estaba diciendo. No importa el ritmo que tengas o cuántas maratones hayas hecho. Tan pronto como te pongas las zapatillas y salgas a la carretera, eres parte del club. Te has unido a la fuerza.
#3 Sentirás El Espíritu De Competencia
No hay nada comparable con la sensación de correr en un gran evento. Tuve la oportunidad de hacer dos maratones hasta que la pandemia nos detuvo a todos, y fue en Madrid 2019 y Valencia 2019, y la experiencia fue la mejor de mi vida. Todo el público apoyándote todo el camino, todos los otros corredores sufriendo contigo y al mismo tiempo disfrutando cada uno de los km desde el inicio hasta el final.
Toda la gente que encuentras cada 10 km te encuentras cada domingo por la mañana cuando el resto de la gente apenas se está levantando y preparando su café, y tú estás en la carretera tratando de superar tu mejor marca personal.
Porque cada vez que corres, estás tratando de superarte. Estás tratando de ser la mejor versión de ti mismo, lo que te ayuda en todos los aspectos de tu vida.
#4 Encontrarás Otra Forma De Descubrir La Ciudad
Usualmente hago dos tipos de sesiones de entrenamiento dependiendo de mi horario y lo que mi cuerpo y mente están demandando para esa sesión. Algunas de ellas que son entrenamientos específicos (series, fartlek, etc.) requieren hacerse en un lugar específico, pero la mayoría del tiempo, solo corro sin la necesidad de estar en un lugar específico y me ayuda a descubrir la ciudad de una manera muy diferente.
Sigo lo que llamo “el camino de las luces verdes”, así que empiezo sin un itinerario específico en mente. Sigo las “luces verdes” en el paso de peatones porque odio detenerme cuando estoy corriendo, así que eso me hace correr por calles en las que nunca he estado (es increíble lo poco que conoces de una ciudad en la que vives) o si estás en otra ciudad por razones de ocio o negocios, es una manera increíble de descubrir una ciudad de una manera muy diferente para abrazarla completamente y conectarte con ella y sentir su alma de una manera muy diferente.
Resumen
Espero que estos puntos destacados siembren dentro de ti si estabas pensando en darle una oportunidad a la Vida de Corredor, y probablemente en este momento estás mirando las zapatillas que tienes en tu armario esperando ser parte de tu rutina desde ahora. Y si ya eres un Corredor, espero que disfrutes y tal vez estés de acuerdo con algunos de estos como los grandes beneficios que usualmente no se mencionan cuando leemos sobre los beneficios de correr.
Este no va a ser uno de esos artículos sobre herramientas que pueden ayudarte a desarrollar código más rápido. Si estás interesado en eso, puedes revisar mis artículos anteriores sobre extensiones de VS Code, linters y otras herramientas que hacen tu vida como desarrollador más fácil.
Mi trabajo no solo trata sobre desarrollo de software, sino también sobre resolver problemas que tienen mis clientes. Aunque sus problemas pueden estar relacionados con el código, pueden ser un error de operación o incluso un problema de diseño.
Usualmente tiendo a definir mi rol como un llanero solitario. Salgo sin saber a qué me enfrentaré, y necesito estar listo para adaptarme, resolver el problema y hacer felices a los clientes. Esta experiencia me ha ayudado a desarrollar una cadena de herramientas que es importante para hacer ese trabajo.
¡Vamos a sumergirnos!
1. MobaXterm
MobaXterm free Xserver and tabbed SSH client for Windows
The ultimate toolbox for remote computing – includes X server, enhanced SSH client and much more!
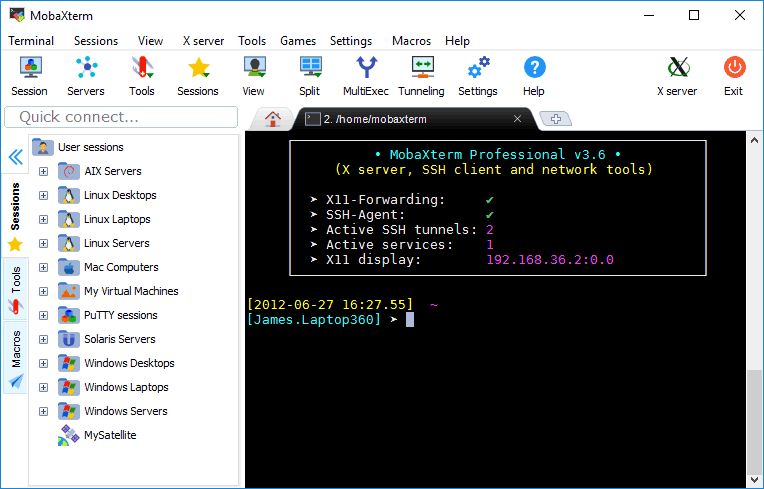
Esta es la mejor herramienta para gestionar diferentes conexiones a diferentes servidores (acceso SSH para un servidor Linux, RDP para un servidor Windows, etc.). Aquí están algunas de sus características clave:
Reenvío de puertos SSH gráfico para esos casos en los que necesitas conectarte a un servidor al que no tienes acceso directo.
Gestión de identidades fácil para guardar las contraseñas de los diferentes servidores. Puedes organizarlas jerárquicamente para facilitar el acceso, especialmente cuando necesitas acceder a tantos servidores para diferentes entornos e incluso diferentes clientes.
Conexión automática SFTP cuando te conectas a un servidor SSH. Te permite descargar y subir archivos tan fácilmente como arrastrar archivos allí.
Reenvío X11 automático para que puedas lanzar aplicaciones gráficas desde tus servidores Linux sin necesidad de configurar nada o usar otros servidores X como XMing.
MobaXterm en acción
2. Beyond Compare
Scooter Software: Home of Beyond Compare
Beyond Compare is a multi-platform utility that combines directory compare and file compare functions in one package. Use it to manage source code, keep directories in sync, compare program output, etc.
Hay tantas herramientas para comparar archivos, y creo que he usado todas ellas — desde aplicaciones independientes como WinMerge, Meld, Araxis, KDiff, y otras hasta extensiones para editores de texto como VS Code y Notepad++.
Sin embargo, ninguna de ellas puede compararse con la única e inigualable Beyond Compare.
Conocí Beyond Compare cuando comencé a trabajar en ingeniería de software en 2010, y es una herramienta que me acompaña en cada proyecto que tengo. La uso todos los días. Entonces, ¿qué hace que esta herramienta sea diferente del resto?
Es simplemente la mejor herramienta para hacer cualquier comparación porque no solo compara texto y carpetas. Lo hace perfectamente, pero al mismo tiempo, también compara archivos ZIP mientras navega por el contenido, archivos JAR, y así sucesivamente. Esto es muy importante cuando queremos verificar si dos archivos JAR que se suben en DEV y PROD son la misma versión de la herramienta o saber si un archivo ZIP tiene el contenido correcto cuando se sube.
Beyond Compare 4
3. Editor Vi
welcome home : vim online
Vim is rock stable and is continuously being developed to become even better. Among its features are:
Este es el más importante — el mejor editor de texto de todos los tiempos — y está disponible prácticamente en cada servidor.
Es un editor de texto de línea de comandos con una gran cantidad de atajos que te permiten ser muy productivo cuando estás dentro de un servidor revisando registros y archivos de configuración para ver dónde está el problema.
Durante mucho tiempo, he tenido una hoja de trucos de Vi impresa para asegurarme de poder dominar los atajos más importantes y así aumentar mi productividad mientras lucho dentro de las líneas enemigas (los servidores del cliente).
Este es otro post de la serie #TIBFAQS y solo para recordarte de qué se trata todo esto es que puedes enviar tus preguntas sobre problemas o dudas de desarrollo de TIBCO y trato de proporcionar una respuesta aquí para intentar ayudar a la comunidad de desarrolladores de TIBCO allá afuera.
Así que hoy voy a comenzar con uno de los que creo que son los problemas más comunes cuando trabajamos con BusinessWorks Container Edition y estamos desplegando en nuestro entorno objetivo y es un rastro similar a este:
Rastro de error respecto a que no puedo leer el perfil
¿Cuál es la causa de este error?
Este error significa que el runtime de BusinessWorks no puede leer y procesar el archivo de propiedades para iniciar la aplicación. Así que eso significa que tu error está relacionado con la configuración de la aplicación y no con la aplicación en sí. Así que, la buena noticia aquí: tu código parece estar bien en este punto.
Como probablemente sabes, todas las aplicaciones de TIBCO BW usan desde hace mucho tiempo un archivo XML para tener los valores de configuración para comenzar. Este es el archivo que en el caso de BusinessWorks Container Edition se almacena en /tmp/tmp/pcf.substvar y se llena de varias fuentes dependiendo de cómo manejes tu configuración.
Como sabes, tienes varias opciones para manejar tu configuración en entornos basados en la nube: Variables de entorno, Mapas de Configuración, Sistemas de Gestión de Configuración como Spring Cloud Config o Consul… Así que es importante que tengas una comprensión clara de lo que estás usando.
Así que el error es que el archivo tiene algo en su contenido que no es válido, porque está mal o porque no puede entenderlo.
Situaciones que pueden provocar este error
Veamos ahora la situación que puede provocar este error y cómo podemos solucionarlo.
1.- Incompatibilidad entre versiones de BW-runtime y EAR
Normalmente, los archivos EAR son compatibles con diferentes runtimes de BusinessWorks, pero esto es cierto cuando el runtime es más actual que el EAR. Así que quiero decir, si genero mi aplicación con BWCE 2.5.0 puedo ejecutarla con runtime 2.5.0, o 2.5.3 o 2.6.0 sin ningún problema, pero si intento ejecutarla con una versión más antigua como 2.4.2 puedo obtener este error porque el archivo EAR tiene algunas «cosas nuevas» que el runtime no puede entender.
Así que es importante validar que la versión del runtime que estás usando es la esperada y actualizarla si ese no es el caso.
2.- Caracteres especiales de XML que necesitan ser escapados
Esta situación solo es cierta en versiones anteriores a la 2.5.0, pero en caso de que estés ejecutando una versión más antigua, también puedes obtener este error porque el valor de tu propiedad tiene un carácter XML que necesita ser escapado. Caracteres como ‘<’ o ‘&’ son los más utilizados para generar este error. Si estás usando una versión más actualizada no necesitas escaparlos porque se escapan automáticamente.
Así que dependiendo de la versión que estés usando, actualiza el valor de tu propiedad en consecuencia.
Resumen
Espero que encuentres esto interesante y si eres uno de los que enfrenta este problema ahora tienes información para no detenerte por este. Si deseas enviar tus preguntas, siéntete libre de usar una de las siguientes opciones:
Twitter: Puedes enviarme una mención a @alexandrev en Twitter o un DM o incluso solo usando el hashtag #TIBFAQs que monitorearé.
Email: Puedes enviarme un correo electrónico a alexandre.vazquez en gmail.com con tu pregunta.
Instagram: Puedes enviarme un DM en Instagram a @alexandrev
#TIBFAQS: No se pudo leer el perfil de [/tmp/tmp/pcf.substvar]
Aprende qué proporciona el Servicio Administrado de Amazon para Prometheus y cómo puedes beneficiarte de él.
El monitoreo es uno de los temas candentes cuando hablamos de arquitecturas nativas de la nube. Prometheus es un proyecto de código abierto graduado de la Cloud Native Computing Foundation (CNCF) y una de las soluciones estándar de la industria cuando se trata de monitorear tu implementación nativa de la nube, especialmente cuando Kubernetes está involucrado.
Siguiendo su propia filosofía de proporcionar un servicio administrado para algunos de los proyectos de código abierto más utilizados pero totalmente integrado con el ecosistema de AWS, AWS lanza una vista previa general (en el momento de escribir este artículo): Servicio Administrado de Amazon para Prometheus (AMP).
Lo primero es definir qué es el Servicio Administrado de Amazon para Prometheus y qué características proporciona. Así que, esta es la definición de Amazon del servicio:
Un servicio de monitoreo totalmente administrado compatible con Prometheus que facilita el monitoreo de aplicaciones en contenedores de manera segura y a escala.
Y me gustaría dedicar algo de tiempo a algunas partes de esta oración.
Servicio totalmente administrado: Entonces, esto será alojado y manejado por Amazon, y solo vamos a interactuar con él usando API como lo hacemos con otros servicios de Amazon como EKS, RDS, MSK, SQS/SNS, y así sucesivamente.
Compatible con Prometheus: Entonces, eso significa que incluso si esta no es una instalación pura de Prometheus, la API será compatible. Así que los clientes de Prometheus que pueden usar Grafana u otros para obtener la información de Prometheus funcionarán sin cambiar sus interfaces.
Servicio a escala: Amazon, como parte del servicio administrado, se encargará de la escalabilidad de la solución. No necesitas definir un tipo de instancia o cuánta RAM o CPU necesitas. Esto será manejado por AWS.
Entonces, eso suena perfecto. Así que puedes pensar que vas a eliminar tu servidor de Prometheus, y comenzará a usar este servicio. Tal vez incluso estés escribiendo algo como helm delete prom… ¡ESPERA ESPERA!
Porque en este punto, esto no va a reemplazar tu servidor local de Prometheus, pero permitirá la integración con él. Así que, eso significa que tu servidor de Prometheus actuará como un recolector para toda la solución de monitoreo escalable que AMP está proporcionando, algo como puedes ver en la imagen a continuación:
Arquitectura de Referencia para el Servicio de Prometheus de Amazon
Entonces, todavía vas a necesitar un servidor de Prometheus, eso es correcto, pero toda la complejidad se evitará y se aprovechará en el servicio administrado: La configuración de almacenamiento, alta disponibilidad, optimización de API, y así sucesivamente, se te proporcionará directamente.
Ingesta de información en el Servicio Administrado de Amazon para Prometheus
En este momento, hay dos formas de ingresar datos en el Servicio de Prometheus de Amazon:
Desde un servidor de Prometheus existente usando la capacidad y configuración de remote_write, lo que significa que cada serie que es recolectada por el Prometheus local será enviada al Servicio de Prometheus de Amazon.
Usando AWS Distro para OpenTelemetry para integrarse con este servicio usando el Receptor de Prometheus y los componentes Exportador de Escritura Remota de AWS Prometheus para obtener eso.
Resumen
Así que esta es una forma de proporcionar una instalación de nivel empresarial aprovechando todo el conocimiento que AWS tiene al alojar y gestionar esta solución a escala y optimizada en términos de rendimiento. Puedes centrarte en los componentes que necesitas para obtener las métricas ingresadas en el servicio.
Estoy seguro de que este no será el último movimiento de AWS en temas de observabilidad y gestión de métricas. Estoy seguro de que continuarán proporcionando más herramientas a las manos de los desarrolladores y arquitectos para definir soluciones optimizadas tan fácilmente como sea posible.
3 beneficios de usar GraphQL en tu API que deberías tener en cuenta.
Todos sabemos que las APIs son el nuevo estándar cuando desarrollamos cualquier pieza de software. Todos los enfoques de paradigma más recientes se basan en una cantidad distribuida de componentes creados con un enfoque colaborativo en mente que necesitan trabajar juntos para proporcionar más valor a todo el ecosistema.
Hablando de la parte técnica, una API se ha convertido en sinónimo de usar REST/JSON para exponer esas APIs como un nuevo estándar. Pero esta no es la única opción incluso en el mundo de solicitud/respuesta sincrónica, y estamos comenzando a ver un cambio en esta selección por defecto de REST como la única opción en esta área.
GraphQL ha surgido como una alternativa que también funciona desde que Facebook lo introdujo en 2015. Durante estos cinco años de existencia, su adopción está creciendo fuera de las paredes de Facebook, pero esto todavía está lejos de los usos del público en general, como muestra el siguiente gráfico de Google Trends.
Gráfico de Google Trends que muestra el interés en REST vs. GraphQL en los últimos cinco años
Pero creo que este es un gran momento para volver a mirar los beneficios que GraphQL puede proporcionar a tus APIs en tu ecosistema. Puedes comenzar un nuevo año introduciendo una tecnología que puede proporcionarte a ti y a tu empresa beneficios claros. Así que, echemos un vistazo a ellos.
1.- Estilo más flexible para satisfacer las necesidades de diferentes perfiles de clientes.
Quiero comenzar este punto con un pequeño salto al pasado cuando se introdujo REST. REST no siempre fue el estándar que usamos para crear nuestra API o Servicios Web, como lo llamábamos en ese momento. Un estándar del W3C, SOAP, era el líder de eso, y REST lo reemplaza, enfocándose en varios puntos.
Sin embargo, el peso del protocolo mucho más ligero que SOAP marca la diferencia, especialmente cuando los dispositivos móviles comienzan a ser parte del ecosistema.
Esa es la situación hoy en día, y GraphQL es un paso adicional en ese enfoque y la perspectiva de ser más flexible. GraphQL permite a cada cliente decidir qué parte de los datos les gustaría usar la misma interfaz para diferentes aplicaciones. Cada uno de ellos seguirá teniendo un enfoque optimizado porque pueden decidir qué les gustaría obtener en cada momento.
2.- Enfoque más desacoplado con el proveedor de servicios
Otro tema importante es la dependencia entre el consumidor de la API y el proveedor. Todos sabemos que diferentes paradigmas como los microservicios se centran en ese enfoque. Nuestro objetivo es obtener tanta independencia como sea posible entre nuestros componentes.
REST no proporciona un gran vínculo entre los componentes, eso es cierto. Aun así, la interfaz está fija al mismo tiempo, por lo que eso significa que cada vez que modificamos esa interfaz agregando un nuevo campo o cambiando uno, podemos afectar al consumidor incluso si no necesitan ese campo para nada.
GraphQL, por su característica de seleccionar los campos que me gustaría obtener, facilita mucho la evolución de la API en sí misma y al mismo tiempo proporciona mucha más independencia para los componentes porque solo los cambios que tienen un impacto claro en los datos que un cliente necesita pueden generar un efecto en ellos, pero el resto es completamente transparente para ellos.
3.- Especificación más estructurada y definida
Uno de los aspectos que definió el auge de REST como un protocolo ampliamente utilizado es la falta de estándares para estructurar y definir su comportamiento. Tuvimos varios intentos usando RAML o incluso solo «muestras como especificación», swagger, y finalmente una especificación OpenAPI. Pero ese tiempo de situación «no estructurada» genera que la API REST pueda hacerse de maneras muy diferentes.
Cada desarrollador o proveedor de servicios puede generar una API REST con un enfoque y filosofía diferentes que generan ruido y es difícil de estandarizar. GraphQL se basa en un Esquema GraphQL que define el tipo gestionado por la API y las operaciones que puedes hacer con él en dos grupos principales: consultas y mutaciones. Eso permite que todas las APIs de GraphQL, sin importar quién las esté desarrollando, sigan la misma filosofía ya que está incluida en el núcleo de la especificación en sí.
Resumen
Después de leer este artículo, probablemente estés diciendo, entonces eso significa que debería eliminar toda mi API REST y comenzar a construir todo en GraphQL. Y mi respuesta a eso es… ¡NO!
El objetivo de este artículo es que seas consciente de los beneficios que diferentes formas de definir API te están proporcionando para que puedas agregarlos a tu cinturón de herramientas, así que la próxima vez que crees una API pienses en estos temas descritos aquí y llegues a una conclusión que sea: mmm creo que GraphQL es la mejor opción para esta situación específica o al revés, no voy a obtener ningún beneficio en esta API específica, así que prefiero usar REST.
La idea es que ahora sepas aplicar a tu caso específico y elegir en base a eso porque nadie mejor que tú para decidir qué es lo mejor para tu caso de uso.